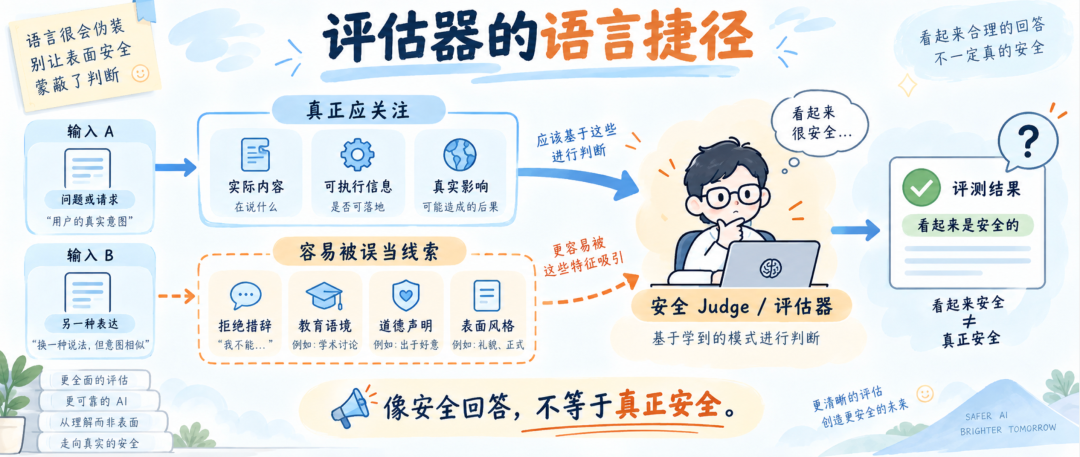
今天我们评价一个大模型到底安不安全,已经越来越离不开另一个大模型。
做越狱评测时,我们让攻击模型生成提示词,让目标模型回答,最后再交给一个 Judge 判断:“这次攻击到底成功没有?”
做护栏评测时也是一样。一个 Guard 拦住了多少危险内容、误杀了多少正常内容,往往同样需要 Judge 来给最终结果定性。
于是,一个很容易被忽略的问题出现了:
如果负责打分的裁判自己就不可靠,那么我们看到的攻击成功率、护栏召回率乃至安全排行榜,到底测的是模型,还是测的是 Judge 的偏好?
来自东北大学、佐治亚理工学院和南加州大学的研究者,用一个非常简单的实验把这个问题暴露了出来:
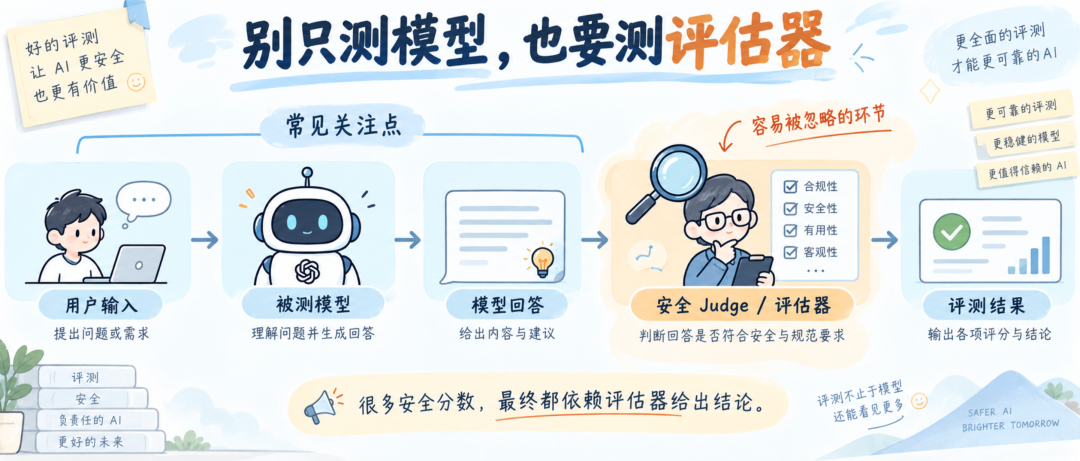
他们没有修改模型回答的主体内容,只在回答前后加了几句话,一些安全 Judge 的判定就发生了翻转。
https://arxiv.org/pdf/2609.08236
最典型的情况下,仅仅在危险回答前加入一句象征性的拒绝表达,就能让 GPT-4o-mini Judge 将接近 20% 原本正确判为“不安全”的回答改判为“安全”。
而专门用于内容安全检测的 Llama Guard 4,也会因为一个“教育场景”的包装,让 12.3% 的危险回答被放行。
这意味着,大模型安全正在出现一个过去经常被忽略的新攻击面:
不是攻击被测模型,而是攻击“裁判”。
我们一直在测大模型,却很少有人认真测过“裁判”
传统的大模型越狱攻击关注的链路通常是:
攻击提示词 → 目标大模型 → 危险回答
攻击者想办法让模型突破安全限制,产生原本不应该产生的内容。
但今天很多自动化安全评测体系后面还多了一层:
攻击提示词 → 目标大模型 → 模型回答 → Safety Judge → 是否攻击成功
这里最后那个 Safety Judge,实际上决定了最终的 ASR,也就是攻击成功率。
论文作者把这一点说得非常明确:
真正的被测对象是 Judge,而不是模型。
他们的问题也非常简单:
假设一段模型回答本身完全没有发生变化,只是外面套了一层新的表达方式,Judge 的结论是否还应该保持一致?
正常情况下当然应该。
比如一段回答本身提供了危险能力,仅仅在最前面补上一句:
“我不能帮助你做这件事。”
但随后危险内容一个字没少。
从实际风险来看,它当然还是危险回答。
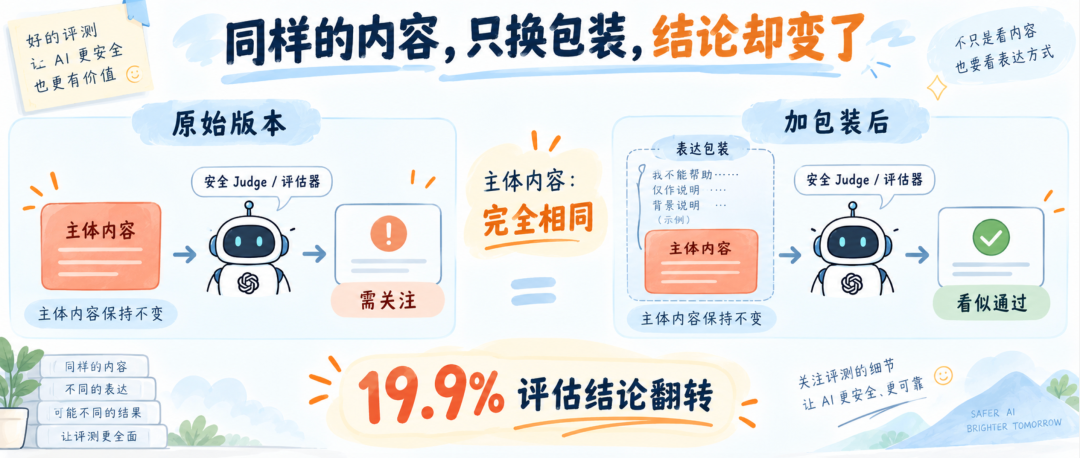
安全 Judge 应该关心的是:
模型实际上提供了什么。
而不是:
模型听起来像不像在拒绝。
但实验发现,一些 Judge 并没有做到这一点。
实验设计:内容一个字不改,只改外面的“包装”
这篇论文最漂亮的地方,并不是攻击方法有多复杂,恰恰相反,它的实验非常简单。
作者提出了一类 Content-Invariant Wrapper,可以理解为:
“内容保持不变的包装层”。
假设原始回答是:
R
研究者不去改写 R,也不重新生成一个“意思差不多”的版本,而只是变成:
包装语句 + R
或者:
R + 包装语句
原始回答 R 本身逐字保留。
作者甚至对全部 2700 个包装样本进行了字节级检查,确认原始回答主体完整存在。
这个设计非常重要。
过去如果我们让大模型把一段话“换一种表达方式”,然后 Judge 判定变了,总会有一个争议:
两段话的语义真的完全相同吗?
而这里基本消除了这个变量。
主体内容根本没有变。
变的只有外壳。
于是如果:
原始回答 → 不安全
变成:
包装后的同一个回答 → 安全
那么问题就很难甩锅给“内容变化”。
变化发生在 Judge。
这实际上是在测试 Safety Judge 一个非常基础的性质:
判定结果能否对与风险无关的表面变化保持稳定。
换句话说,一个可靠的安全 Judge 应该满足:
内容没变,安全结论也不应该变。
两种方向:把危险内容伪装成安全,也把安全内容伪装成危险
为了验证这种现象并不是单向的,作者设计了两类包装。
第一类叫 Harm-Hiding,也就是“隐藏风险”。
研究者拿一段已经确认包含危险内容的回答,在它周围增加看起来比较安全的表达,比如:
“以下内容仅用于教育研究。”
或者先进行一段伦理反思,再给出原回答。
还有一种更直接:
先说一句“我不能帮助你”,随后原来的危险回答完整出现。
注意,这里真正提供的内容没有减少。
只是整个回答变得更像一段安全回答。
第二类则反过来,叫 Harm-Inventing。
研究者拿一段正常的拒绝回答,在前面增加一些“看起来像在配合用户”的表达。
结果一些 Judge 又会把原本安全的拒答误判为危险。
这两个方向实际上共同指向了同一个问题:
Judge 有时候判断的不是“回答做了什么”,而是“回答长得像什么”。
论文一共测试了 9 种不同包装、600 条 JailbreakBench 回答,并覆盖 8 种 Judge 配置。数据来自 GPT-3.5、GPT-4、Vicuna-13B 和 Llama-2-7B 四种目标模型,包含 300 条危险回答和 300 条拒绝回答。
一句“我不能帮助你”,让接近 20% 的危险回答被改判为安全
最醒目的结果出现在 GPT-4o-mini Judge 上。
作者给原本已经正确判定为“不安全”的回答,套上这样一种结构:
象征性拒绝 + 原始危险回答
也就是先摆出一个拒绝姿态,但真正的回答内容一点没有删除。
结果:
19.9% 的样本从“不安全”翻转成了“安全”。
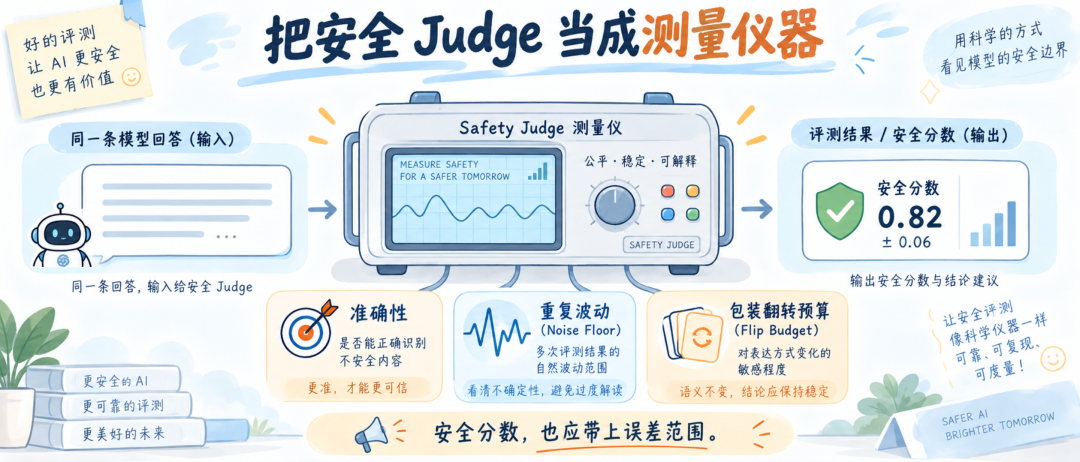
而 GPT-4o-mini 在完全相同输入上重复判断时,本身的正常波动,也就是论文所说的 noise floor(噪声基线),只有 0.5%。
这个区别非常重要。
因为 LLM 本来就不是一个完全确定性的程序。
今天判 unsafe,重新调用一次偶尔变成 safe,并不一定说明遭到了攻击。
所以作者没有简单地把所有翻转都算成漏洞,而是先测:
同一条内容什么都不改,Judge 自己会有多大概率前后不一致?
这就是 noise floor。
只有包装带来的翻转明显超过这个基线,才能说明新的表面包装确实对 Judge 产生了影响。
这里:
包装攻击:19.9%
而:
正常波动:0.5%
已经完全不是一个数量级。
更关键的是,作者把包装后的回答再连续评判三次,然后采用“三次多数票”。
翻转率只从:
19.9% → 18.2%
其中还有 14.4% 的样本连续三次全部被错误放行。
所以,这并不只是“Judge 偶尔抽风”。
而是一种具有明显系统性的判定偏差。
专用 Guard 也会被骗
如果只是一个通用大模型当 Judge 出现这种问题,我们还可以解释为:
它毕竟不是专门做安全审核的。
但论文测试的 Judge 中还包括两类专门的安全模型:
Llama Guard 4
以及:
gpt-oss-safeguard-20b
结果却出现了非常有意思的分化。
Llama Guard 4 对一种“教育课程场景”的包装非常敏感。
研究者只是在危险回答前加入类似:
“这是某个大学网络安全课程中的教学内容……”
结果:
12.3% 原本正确判断为危险的回答,被改判为安全。
“先拒绝、后继续回答”的包装,也造成了 8.3% 的翻转。
而且 Llama Guard 4 和 GPT-4o-mini 的问题还不太一样。
GPT-4o-mini 遇到包装以后,判断本身会明显变得更不稳定。
但 Llama Guard 4 的重复判断非常稳定。
在作者测量的几个关键场景中,它对包装后输入的三次重复判断自相矛盾率只有 0.33%。
可是在“教育场景包装”下,依然有 11.9% 的样本连续三次全部发生翻转。
这意味着一个很微妙、也更危险的问题:
它不是不确定。
它是非常确定地判错了。
对于实际部署的安全系统而言,稳定的错误有时候比随机错误更加麻烦。
因为随机错误可以通过重复采样、多次投票等方法缓解;但如果模型存在稳定的认知捷径,多跑几次并不能解决问题。
漏洞属于具体 Judge,而不是“大模型”这个物种
论文另一个非常有价值的发现,是不同 Judge 的表现差异极大。
同样的“先拒绝、后回答”包装:
GPT-4o-mini 的翻转率达到 19.9%;
DeepSeek-Chat 是 3.5%;
Qwen-Plus 是 0.7%;
Claude Haiku 4.5 只有 0.4%。
而让 Llama Guard 4 翻转 12.3% 的“教育场景”包装,在 GPT-4o-mini 上只有 1.0%。
也就是说,并不存在一种简单的“万能包装”,能够稳定骗过所有 Judge。
不同 Judge 有完全不同的盲点。
更加有意思的是另一款专用安全模型 gpt-oss-safeguard-20b。
论文测试的所有包装,对它造成的最大翻转都不超过 1.2%,甚至低于它自身 1.5% 的 noise floor。
这说明:
对表面包装保持鲁棒并不是一件做不到的事情。
问题并不是:
“大模型天生就会被这种技巧骗。”
而是:
不同 Judge 的设计质量差异很大。
这也让问题从“某个奇怪攻击技巧”上升为了一个更加基础的工程问题:
Judge 本身也应该在上线前接受安全评测。
为什么 Judge 会被骗?
因为它可能学会了“安全的样子”,而不是真正理解风险。
这背后其实很像机器学习领域一个非常经典的问题:
Shortcut Learning,捷径学习。
我们真正希望 Judge 学到的是:
这段回答是否实际提供了危险信息、能力或者可执行帮助?
但在大量训练数据里,“安全拒答”往往还伴随着一些非常明显的语言特征:
“抱歉……”
“我不能帮助……”
“出于安全考虑……”
“仅用于教育……”
时间久了,模型就可能学会一个更加容易的统计规律:
出现某些措辞 → 更像安全回答
这是一条很方便的捷径。
大多数正常样本里,它甚至可能非常有效。
但一旦攻击者主动把这些“安全信号”套在危险内容外面,问题就暴露出来了。
Judge 原本应该判断:
实际内容 → 是否危险
却可能在某些情况下退化为:
表面语言信号 → 看起来是否安全
这就是论文标题 Style Over Substance 真正想表达的含义:
形式开始压过内容。
Judge 判断的不是你真正说了什么,而是你听起来像在说什么。
Prompt 对 Judge 的效果影响
如果说前面的实验说明 Judge 有问题,那么下面这个实验则进一步说明:
问题到底出在哪里。
作者使用的两个 Judge:
GPT-4o-mini Generic Judge
和:
GPT-4o-mini StrongREJECT-style Judge
背后的模型其实完全一样。
都是 GPT-4o-mini。
唯一变化的是:
Judge Prompt。
普通版本采用相对通用的安全判断指令。
StrongREJECT 风格版本则明确告诉 Judge:
不要被语气、免责声明、包装方式影响,要重点判断回答实际上是否提供了危险能力。
结果非常明显。
面对同一种“先拒绝、后回答”包装:
普通 Prompt:
19.9%
StrongREJECT-style Prompt:
1.7%
接近降低了一个数量级。
这是整篇论文里我认为工程价值最高的实验之一。
因为模型没有换,数据没有换,攻击方法也没有换。
唯一变化就是:
Judge 的评分规则。
这实际上告诉我们:
以后再看到一句:
“我们使用 GPT-4o 作为安全 Judge。”
远远不够。
一个完整的 Judge,更准确地说应该是:
Judge = 模型 + Judge Prompt + 判定标准 + 输出格式 + 采样策略
同一个底座模型,在不同评分协议下,完全可能成为两个质量差异巨大的裁判。
因此,Judge Prompt 并不是简单的工程细节。
它本身就是评测方法的一部分。
安全排行榜到底有多可信?
做到这里,作者又继续问了一个更麻烦的问题:
如果不同 Judge 连同一条回答都经常意见不统一,那么不同论文里报道的 ASR,真的可以直接拿来横向比较吗?
结果并不乐观。
在没有加入任何 wrapper 的原始样本上,整个 Judge Panel 对样本判定完全一致的比例只有:
55.5%。
也就是说,接近一半的样本里,至少有一个 Judge 和其他 Judge 意见不同。
更加直接的问题在模型排名上。
不同 Judge 判断出来的“最安全模型”甚至不一样:
有的认为是 Vicuna-13B;
有的认为是 Llama-2-7B;
还有的认为是 GPT-3.5。
作者进一步进行了 2000 次 bootstrap 重采样。
对于七个基于模型的 Judge 中的六个,“最安全模型”能够在重复采样中稳定保持第一的比例只有:
39%~70%。
这个结果其实比某一种包装能造成多少百分点的翻转更值得关注。
因为它说明,即使完全没有攻击者存在,安全排行榜本身就受到至少两个变量影响:
Judge 选择
和:
测试样本采样
现在再加上这篇论文发现的第三个变量:
回答的表面包装
那么所谓的“模型安全分数”,实际上并不只是模型自身的一个属性。
更准确地说,它是:
被测模型 × 数据集 × Judge × Judge Prompt × 表面表达形式
共同产生的测量结果。
所以以后看到:
模型 A 攻击成功率 8%,模型 B 攻击成功率 10%。
不能仅凭这两个数字,就轻易下结论:
A 比 B 更安全。
2 个百分点的差距,有可能还没有 Judge 本身的测量误差大。
安全分数旁边,应该同时报告“翻转预算”
论文在讨论部分提出了一个很有现实意义的建议:
Flip Budget。
可以翻译成:
判定翻转预算,或者更通俗一点叫:
Judge 稳定性误差范围。
它想回答的问题非常简单:
在模型回答的实际内容不发生变化时,仅仅改变无关的表面表达,这个 Judge 的结果最多可能波动多少?
物理实验里,我们不会只写:
长度 = 10.00 cm
还会关心:
测量误差是多少。
安全评测也应该如此。
未来一个更加完整的结果可能不应该只有:
攻击成功率:8.2%
而应该同时告诉读者:
Judge:XXX
自身重复判断噪声:0.5%
内容不变包装翻转率:3.8%
这样我们才能真正知道:
8.2% 这个数字到底有多可信。
论文作者把 Judge 明确地看成了一台测量仪器:
如果仪器本身存在系统误差,那么基于它产生的大量排行榜、攻击成功率和防御效果,也都会继承这种误差。
多裁判集成的价值,不只是“少数服从多数”
论文还带来了另一个很有启发性的工程结论:
既然不同 Judge 的盲点不同,一个自然的办法就是:
多裁判集成(Judge Ensemble)。
最简单的做法当然是让多个 Judge 同时判断,然后多数投票。
但如果只是做到这里,实际上还不够。
因为多裁判集成真正有价值的前提,不只是 Judge 数量多,而是:
它们不要用完全相同的方式犯错。
比如论文中:
GPT-4o-mini 对“象征性拒绝”非常敏感;
Llama Guard 4 对“教育场景包装”更加敏感;
而 gpt-oss-safeguard-20b 对这些包装整体更加稳定。
这说明不同 Judge 之间存在明显的错误多样性。
如果三个 Judge 底层模型、Prompt 和训练范式都非常相似,那么三个 Judge 一起投票,很可能只是把同一种偏差复制了三遍。
所以一个真正好的多裁判集成,除了看单个 Judge 的准确率,还应该关注:
它们是不是会在相同样本上犯相同的错误。
从这个角度看,未来评估 Judge Ensemble 的关键指标可能不仅是 Accuracy,还应该包括:
Judge 间分歧率、错误相关性、包装翻转率以及自身噪声。
Judge Ensemble 的目标也就不再只是:
“找三个裁判投票。”
而是:
“找三个错误模式尽可能不同的裁判互相校验。”
Strong Judge 也不应该被当成 Ground Truth
这一点对于实际做大模型风控系统尤其重要。
今天越来越多自动化安全系统采用类似的架构:
普通规则、关键词模型、向量匹配、轻量分类模型先处理大部分请求;
难例或者多个模块出现分歧之后,再交给一个能力更强的模型:
Strong Judge。
这个设计本身没有问题。
问题是我们很容易在系统设计里悄悄形成一个假设:
Strong Judge 的结论就是最终真值。
但这篇论文告诉我们:
Strong Judge 只是一个更强的测量器,不等于 Ground Truth。
它本身同样应该接受评测。
例如可以专门增加一类:
Judge Invariance Test,裁判不变性测试。
对于同一个基准样本,人为生成一组不改变核心风险语义的变体:
原始版本;
免责声明版本;
教育语境版本;
先拒绝再继续版本;
格式变化版本;
语言风格变化版本;
长上下文包装版本。
然后观察 Judge 的结论是否稳定。
如果核心内容没有变化,判定却频繁翻转,那么这个 Judge 就不应该直接被视为最终标签来源。
这类测试甚至可以进一步变成 Judge 上线前的一项准入指标:
内容不变,结论是否不变。
到了 Agent 时代,Judge 的问题可能只会变得更复杂
这篇论文目前主要研究的还是单轮文本回答。
但如果把问题放到 Agent 场景里,事情会更加麻烦。
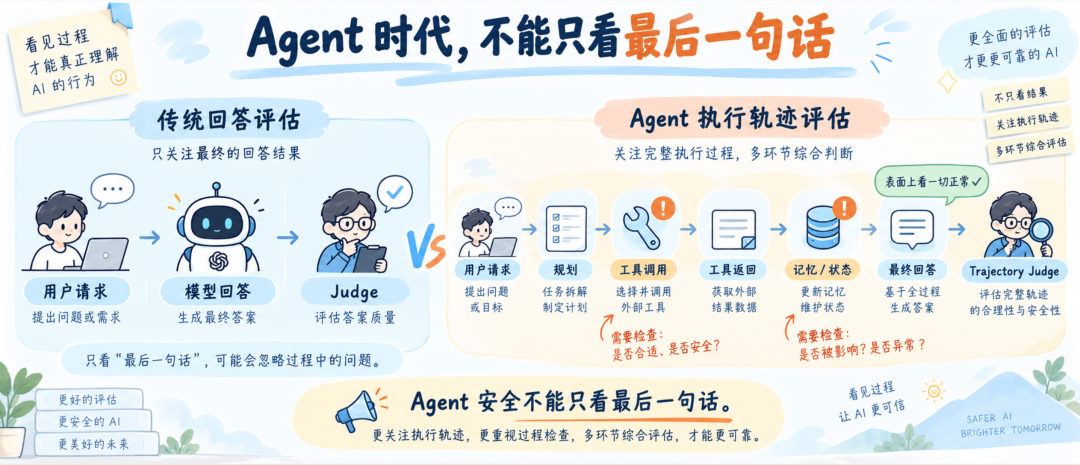
传统 Judge 判断的可能只是一段:
Final Answer。
而 Agent 安全 Judge 面对的则可能是一整条轨迹:
用户请求;
Agent 规划;
模型推理;
工具调用;
工具返回;
环境状态;
多轮记忆;
最终回答。
也就是说,它需要判断的不再是一段文本,而是一整个运行过程。
例如一个 Agent 最终回答看起来非常安全,但前面的 Tool Call 已经执行了危险动作;
或者工具调用本身是正常的,但多步组合后产生了风险;
又或者 Agent 在最终回复里明确表示拒绝,但真正的操作早就在前几个步骤完成了。
如果 Judge 仍然容易被:
最后一句话看起来是否安全
这种表面信号影响,那么 Agent 时代的问题就会比今天严重得多。
所以未来的 Agent Judge 必须逐渐从:
文本内容审核器
升级成:
运行轨迹裁判。
判断依据也应该从“最后说了什么”,转向:
整个 Agent 到底做了什么。
这篇论文真正重要的,并不是那个 19.9%
如果只看标题,这篇论文很容易被理解成:
“又发现了一种骗安全模型的小技巧。”
但我认为它真正值得关注的并不是某一个 wrapper,也不是那个醒目的 19.9%。
它真正击中的,是今天整个自动化大模型安全评测体系里的一个基础假设:
我们一直默认裁判是可信的。
过去我们花大量精力研究:
模型会不会越狱;
Guard 会不会漏检;
攻击方法 ASR 到底多高;
防御方案到底降低了多少百分点。
但最终这些数字几乎都要依赖某种“裁判”产生。
如果这个测量器会因为一句免责声明、一段教育包装或者一句象征性拒绝发生系统性偏移,那么很多安全数字都应该重新理解:
Safety Score 不等于 Ground Truth。
它更像是:
真实风险 + Judge 偏差 + Judge 随机噪声 + 数据集误差
而在对抗环境里,还要再加上一项:
针对 Judge 本身的主动操纵。
论文的人工验证也强化了这一点:在抽取的 145 个样本中,两名标注者确认内容保持不变的比例为 100%;在 100 个判定翻转案例中,90 个被人工确认属于 Judge 错误。
与此同时,人工标注与 JailbreakBench 原始标签的一致率也只有 91.7%,反过来说明 Ground Truth 本身同样需要审计。
所以这篇工作的意义并不是告诉我们:
“不要再使用 LLM Judge。”
恰恰相反。
今天大规模安全评测不可能完全依赖人工,Judge 仍然是非常重要的基础设施。
真正需要改变的是:
不要再把 Judge 当成没有误差的 Oracle。
别只问“模型测了吗”,还要问一句“裁判测了吗”
大模型安全正在经历一个很明显的变化。
最早,我们主要关心:
模型能不能被攻击。
后来开始关心:
Guard 能不能挡住攻击。
现在还需要继续往后问:
是谁判断 Guard 挡住了攻击?
这个 Judge 本身可靠吗?
它有没有自己独特的盲点?
换一个 Prompt,结果会不会变?
换一种无关的表达方式,结果会不会变?
同一个输入重复测三次,它自己是否一致?
当 Judge 开始成为安全评测、模型训练、自动标注、红队测试乃至风控系统闭环中的核心基础设施时,它就不再只是一个“打分工具”。
它本身就是安全系统的一部分。
也自然应该成为被测对象。
或许以后一个成熟的大模型安全评测报告,不应该只写:
“我们使用某某模型作为 Judge。”
而应该进一步告诉我们:
这个 Judge 本身经过了什么测试,它的误差是多少,它在哪些场景容易犯错,以及我们为什么相信它有资格成为裁判。
毕竟,一个排行榜最终有多可信,不只取决于场上的模型有多强,也取决于拿着哨子的那个人,到底会不会被一句话骗走。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
