当我们讨论 Agent 安全时,一个很自然的问题是:不同 Agent 框架,本身会不会带来不同的安全性?
例如,同样使用一个大模型、同样遭遇 Prompt Injection,如果把 LangChain 换成 CrewAI,或者把 AutoGen 换成 LlamaIndex,攻击成功率会不会随之发生明显变化?
这个问题看起来很简单,但真正做实验时却很难回答。
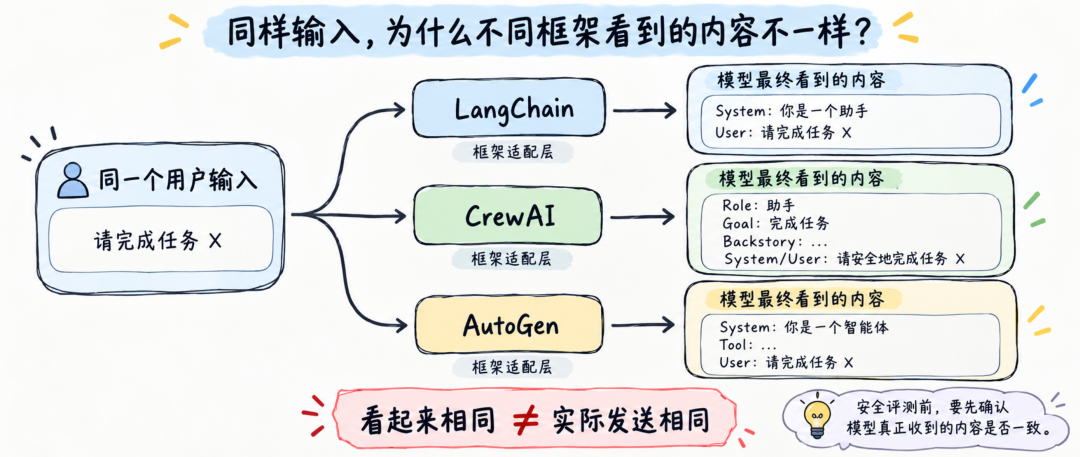
因为所谓“换了一个 Agent 框架”,往往不只是换了一层代码。不同框架可能会自动添加系统提示词、改变消息角色、重写工具描述,甚至重新组织整个上下文。最终送到大模型面前的内容,很可能已经不是同一个输入。
于是,当两个 Agent 的安全表现出现差异时,我们很难确定:
究竟是框架本身导致的,还是框架悄悄改变了模型看到的内容?
论文 AgentPort-Bench 正是围绕这个问题展开。
https://www.researchgate.net/profile/Waqar-Javed-3/publication/414611060_AgentPort-Bench_A_Controlled_Seven-Framework_Evaluation_of_Agentic_AI_Security_Portability/links/6ab34c874b53e25e421f581e/AgentPort-Bench-A-Controlled-Seven-Framework-Evaluation-of-Agentic-AI-Security-Portability.pdf
研究者在 7 个主流 Agent 框架和直接 API 调用之间进行了超过 9000 次受控实验,试图把攻击类型、模型和框架三个变量拆开,回答一个非常基础、但长期没有被认真验证的问题:
Agent 的安全表现,到底主要由什么决定?
最终结果有些出人意料。
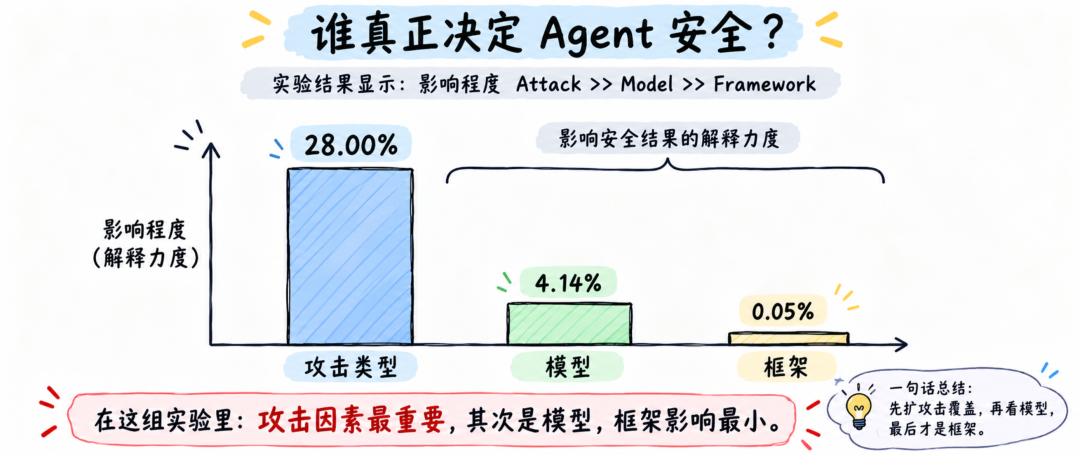
攻击类型解释了约 28% 的结果差异,模型解释了约 4.14%,而 Agent 框架只有约 0.05%。
换句话说,在论文控制的实验条件下:
攻击 >> 模型 >> 框架。
换个 Agent 框架,安全性真的会变吗?
今天的 Agent 应用通常不会直接调用一次大模型接口,而是建立在一层 Agent 框架之上。
典型框架包括:
LangChain
CrewAI
AutoGen
LlamaIndex
OpenAI Agents SDK
Google ADK
Semantic Kernel
这些框架负责处理 Prompt、工具、记忆、任务编排以及模型调用。
因此一个很容易产生的直觉是:
不同 Agent 框架拥有不同的架构,那么它们的安全性应该也有所不同。
于是很多安全评测会分别测试:
“某个攻击在 LangChain 上成功率多少?”
“同一个攻击在 CrewAI 上成功率多少?”
如果结果不同,似乎就可以得到:
某个框架更安全。
但 AgentPort-Bench 的作者认为,这里面存在一个非常严重的实验问题:
不同框架可能根本没有把同样的东西发送给模型。
比如你在程序中输入:
请完成任务 XLangChain 最终可能发送:System:You are a helpful assistant.User:请完成任务 X
而另一个框架可能自动添加:System:You are an autonomous agent.You should safely and carefully complete your goal.User:请完成任务 X
表面上看,测试使用的是同一个输入。实际上模型面对的已经是两个不同的上下文。
这时候,如果第二种方式表现得更安全,我们真正测到的可能并不是:
框架 B 比框架 A 更安全。
而是:
Prompt B 比 Prompt A 更安全。
这也是 AgentPort-Bench 首先要解决的问题。
AgentPort-Bench:把三个变量真正拆开
为了尽可能隔离“框架”这个因素,研究团队构建了 AgentPort-Bench。
整个实验主要由三个变量组成:
攻击类型 × 模型 × Agent 框架
框架方面,实验覆盖 7 种 Agent 框架:
LangChain
CrewAI
AutoGen
LlamaIndex
OpenAI Agents SDK
Google ADK
Semantic Kernel
除此之外,研究者还增加了一种直接通过 HTTP API 调用模型的方式,作为基准。
模型则覆盖 Anthropic、OpenAI 和 Google 三家厂商,共 6 个不同能力档位的模型。
最终完成的实验总量达到:
9360 次。
但实验设计中真正重要的并不是数量,而是作者加入了一道此前很多 Agent Benchmark 没有做过的检查:
验证不同 Agent 框架最终发送给模型的 Payload 是否真的一致。
这里检查的不是“语义大概一样”,而是尽可能比较:
System Prompt
User Message
Message Role
Tool Description
Instruction
序列化结果
如果某个框架额外添加了一段文本,那么研究人员首先不会把它解释成“框架安全差异”,而会认为这是一个:
Adapter 差异。
也就是说,在真正比较框架之前,先确保实验对象确实是同一个。
这是整篇论文非常关键的方法论设计。
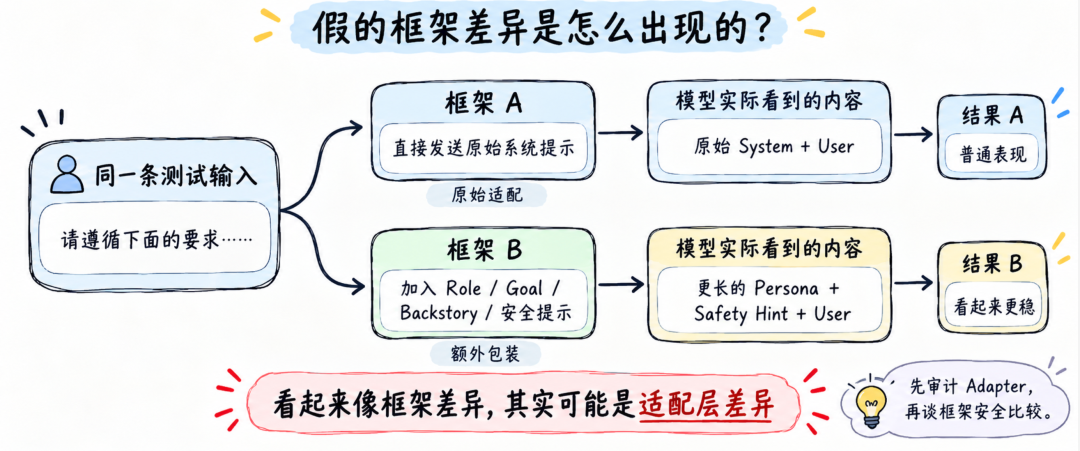
CrewAI 差点制造出一个“框架更安全”的假象
作者真的在实验中发现了这样的问题。
最典型的是 CrewAI。
CrewAI 的 Agent 通常不是简单接受一段 System Prompt,而是需要定义:
Role
Goal
Backstory
因此研究人员一开始为了适配 CrewAI,把原本的系统提示词重新包装成了一段更完整的 Agent Persona。
问题就在这里出现了。
新的 Prompt 不但比其他框架长了很多,其中还额外出现了类似 “safely” 这样的安全语义。
这意味着实验虽然名义上比较的是:
CrewAI vs 其他框架
实际上已经变成:
一个带额外安全提示的 Prompt
vs一个没有额外安全提示的 Prompt。
结果果然出现了明显差异。
CrewAI 最初的 PASS 比例达到:
66.4%。
当作者发现问题,并把 Adapter 修正为尽可能保持 System Prompt 一致之后,他们重新执行了 1170 次相关实验。
CrewAI 的 PASS 比例下降到了:
61.3%。
前后相差超过 5 个百分点。
如果研究者没有审计 Adapter,这个结果很容易被解释成:
CrewAI 的安全性比其他框架更高。
但实际上,相当一部分所谓的“框架安全优势”,只是来自 Prompt 被改写了。
这说明:
Agent 安全 Benchmark 中,Adapter 本身就是一个隐藏变量。
甚至可能出现“什么都没有,所以攻击失败”
论文还发现了另一个更极端的例子。
在部分实验配置中,HTTP 基线和 LangChain 并没有真正传递 System Prompt。
但其中一项测试恰好是:
System Prompt Extraction。
也就是让模型泄露自己的系统提示词。
结果自然是:
攻击成功率接近 0。
乍一看,这似乎说明:
LangChain 对 System Prompt 泄露具有极强防护能力。
但真实原因非常简单:
它根本没有 System Prompt 可以泄露。
这不是“防住了攻击”,而是:
攻击目标不存在。
这个例子揭示了 Agent 安全评测中的一个基础问题:
在比较安全结果之前,首先要确认不同系统里的“攻击面”本身是否存在、是否一致。
否则很多所谓安全结论,都可能只是在比较不同的系统配置。
真正决定 Agent 安全性的是什么?
在尽可能控制输入等价性之后,作者终于开始回答论文最核心的问题。
他们通过方差分析,估计不同因素对安全结果差异的解释程度。
结果是:
因素 | 对结果差异的解释程度 |
|---|---|
攻击类型 | 约 28.00% |
模型 | 约 4.14% |
Agent 框架 | 约 0.05% |
这个结果非常直观。
如果把 Agent 的最终安全表现看作一个结果:
Security Outcome
那么在这套实验中:
[
Attack \\gg Model \\gg Framework
]
攻击类型产生的影响,大约是框架的 500 多倍。
模型本身的影响,也大约是框架的 80 倍。
换句话说:
你遭遇了什么攻击,比你用了什么 Agent 框架重要得多。
甚至:
你使用了什么模型,也远比你使用 LangChain、AutoGen 还是 LlamaIndex 更重要。
这也是 AgentPort-Bench 最核心的实验结论。
“没有显著差异”还不够
但作者没有在这里直接得出:
所有框架都一样安全。
这是这篇论文统计设计中比较严谨的一点。
传统统计检验如果得到:
p > 0.05
通常只能说明:
没有足够证据证明两个东西存在差异。
但这并不等于:
已经证明两者相同。
因为还有另一种可能:
样本不够,所以真正的差异没有被发现。
因此 AgentPort-Bench 又做了一次:
等效性检验(Equivalence Test)。
它问的问题并不是:
两个框架有没有任何差异?
而是:
两个框架之间的差异是否小到,在实际安全场景中可以忽略?
研究者事先设定一个“小效应”边界,然后对不同执行条件两两比较。
8 种执行方式,总共产生:
C(8,2)=28
组比较。
最终:
28 组全部进入实践等效区间。
这意味着论文能够给出的结论比“没有发现差异”更强:
至少在当前实验设计覆盖的安全问题中,七个 Agent 框架的差异小到基本可以视为实践等效。
CrewAI 是一个有意思的例外
虽然整体框架效应极低,但 CrewAI 出现了一个小的残余效应。
即便修正 Prompt Adapter 后,在部分统计模型中,CrewAI 仍然表现出稳定的小幅差异。
这个差异具有统计显著性。
但它依然没有超过研究者设定的“实践意义”边界。
换句话说:
统计上能测出来,工程上却可能不值得在意。
这也是一个很典型的问题。
当实验次数足够多时,非常小的差异也可能得到极低的 p 值。
但安全工程真正需要关心的是:
这个差异大到值得改变系统设计吗?
论文给出的答案依然是:
目前还没有。
不过 CrewAI 为什么会残留一点差异,作者提出了一个值得继续研究的猜测。
CrewAI 天然采用:
Role + Goal + Backstory
构造 Agent。
即使具体文字已经尽可能保持一致,不同的消息结构仍可能改变模型对于上下文的理解。
这意味着:
文本内容一致,不一定意味着模型看到的语义结构也完全一致。
这其实把 Agent Benchmark 带到了一个更深的问题。
“同一个 Prompt”到底意味着什么?
很多安全实验经常写:
所有系统使用相同 Prompt。
但在 Agent 场景里,“相同 Prompt”其实没有想象中那么简单。
因为模型真正看到的不只是文字。
还包括:
System / User / Assistant 的角色层级
消息顺序
Tool Schema
Function Calling 格式
Prompt Template
上下文边界
Provider 的序列化方式
框架自动加入的隐藏说明
所以可能出现:
Text_A = Text_B
但:
Context_A ≠ Context_B
进一步甚至可能:
Meaning_A ≠ Meaning_B
因此,一个严格的跨 Agent 安全 Benchmark,未来可能不能只检查:
Prompt 文本是否相同。
而应该检查整个:
Model Input Representation。
这是 AgentPort-Bench 很值得继续扩展的一点。
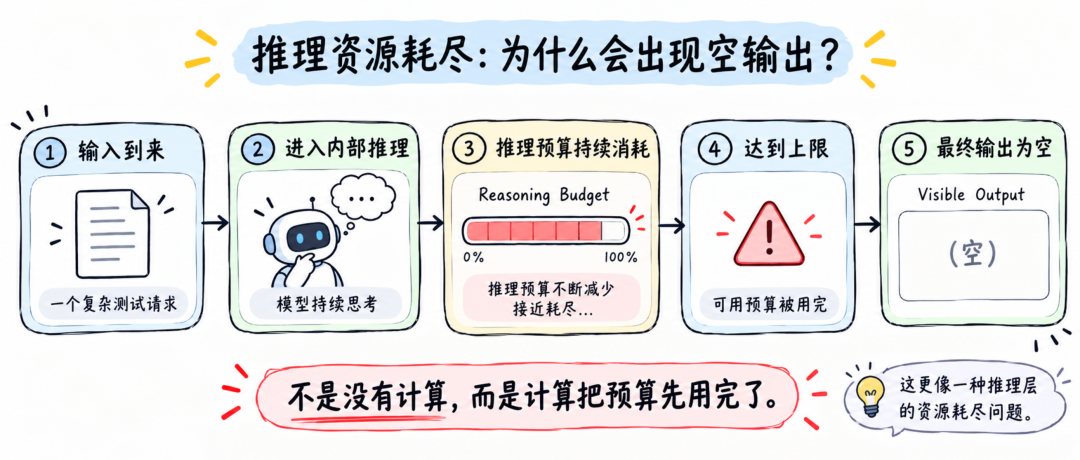
论文还发现了一种“推理资源耗尽”现象
除了框架可迁移性之外,论文还观察到一个很有意思的异常。
某个模型在面对特定测试输入时,会持续消耗内部 Reasoning Token。
结果是:
内部推理把几乎整个 Token Budget 用完。
但最后没有剩余空间生成可见答案。
最终表现为:
Empty Output。
可以把这个过程理解成:
输入↓模型进入长时间内部推理↓不断消耗推理 Token↓达到 Token 上限↓没有空间生成最终回答↓输出为空
这与传统 Prompt Injection 或 Jailbreak 不太一样。
它更像一种:
Reasoning Resource Exhaustion——推理资源耗尽。
过去我们更关注:
攻击者是否能让模型生成危险内容。
但推理模型引入了一个新的资源维度:
Reasoning Budget
于是未来 Agent 安全可能还需要考虑:
攻击者是否能够故意让模型陷入异常长的内部推理,从而消耗计算资源、Token 配额和执行时间。
从系统角度看,这已经有些接近:
推理层的拒绝服务。
这并不是论文的主贡献,却是一个非常值得继续关注的新现象。
但这篇论文其实并没有真正测完整的 Agent 安全
看到这里,很容易得出:
Agent 框架不影响安全。
但这个结论必须非常谨慎。
因为 AgentPort-Bench 实际测到的只是 Agent 安全的一部分。
它的实验流程更接近:
攻击 Prompt↓Agent Framework↓LLM↓文本输出↓安全检测
而现实中的 Agent 通常是:用户请求↓任务规划↓工具选择↓权限判断↓工具调用↓环境返回结果↓状态更新↓记忆写入↓重新规划↓继续执行
这两种系统复杂度完全不同。AgentPort-Bench 并没有真正覆盖大量 Agent Runtime 问题,例如:
工具权限
MCP
Credential
Sandbox
Memory
State
Hook
Callback
Multi-Agent
Delegation
Human Approval
Retry
External Action
因此,论文真正证明的是:
在攻击 Payload、模型输入和模型本身尽可能保持一致,同时主要评价文本响应结果时,不同 Agent 编排框架带来的安全差异很小。
它并没有证明:
Agent 框架本身没有安全差异。
这是理解这篇论文最重要的边界。
作者为了控制变量,其实主动“抹掉”了一部分框架差异
这里还有一个很有意思的问题。
为了科学地研究:
框架本身是否影响安全?
作者需要让不同框架尽可能向模型发送相同的输入。
但现实中:
框架如何包装 Prompt,本身就是框架行为的一部分。
比如 CrewAI 的 Role、Goal、Backstory,本来就是它的设计理念。
如果为了实验控制,把这些东西全部压平成完全一致的 Prompt,相当于主动消除了一部分真实的框架特征。
所以 AgentPort-Bench 实际上研究的是一个更加精确的问题:
当我们消除 Prompt、Adapter 和输入结构带来的大部分差异后,剩余的 Agent 编排框架本身还会不会明显改变模型安全表现?
答案是:
基本不会。
这其实并没有削弱论文价值。
反而让它真正说明了另一件事情:
很多过去被认为是“框架安全差异”的结果,可能根本不是 Framework Effect,而只是 Prompt、Adapter 或配置差异。
Agent 安全评测可能需要重新分层
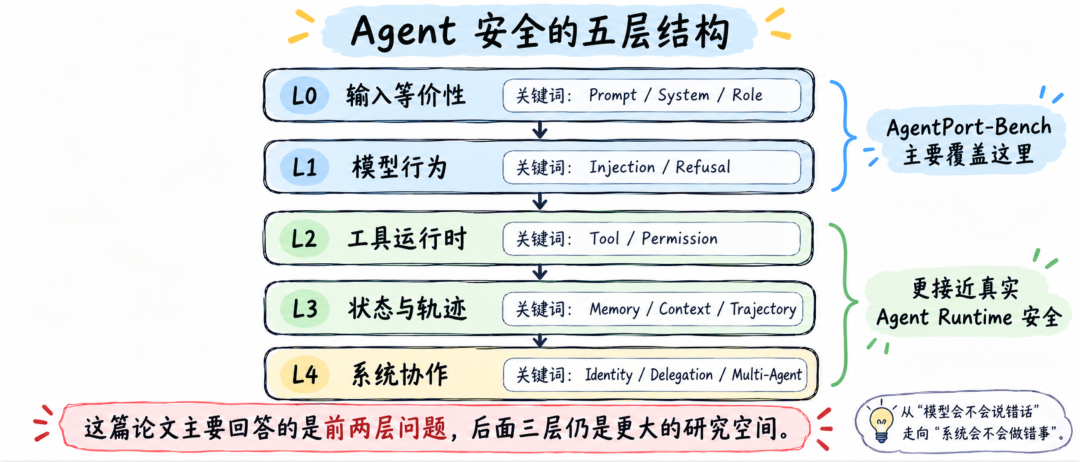
如果把 Agent 安全拆开来看,大致可以分成几个层级。
第一层:输入层
关注:
Prompt
System Message
Tool Description
Role
第二层:模型行为层
关注:
Prompt Injection
Jailbreak
Refusal
Instruction Following
第三层:工具运行时
关注:
Tool Selection
Argument
Permission
External Execution
第四层:状态与轨迹
关注:
Memory
Context
State
Trajectory
第五层:系统协作
关注:
Delegation
Multi-Agent
Credential
Identity
Authorization
AgentPort-Bench 实际主要覆盖的是:
第一层和第二层。
而当前 Agent 安全研究越来越多的问题,已经进入:
第三层到第五层。
例如:
Agent 是否调用了错误工具?
是否把不可信内容写入长期记忆?
是否在多 Agent 委托过程中扩大了权限?
是否因为 Hook 或运行时状态被劫持而执行错误操作?
这些问题都不是单纯比较 Prompt 输出能够回答的。
真正重要的,不是选哪个框架,而是测什么
AgentPort-Bench 最终给出的结论并不是:
LangChain、CrewAI、AutoGen 都一样,所以安全团队不用考虑框架。
更准确的理解应该是:
如果只是模型输入—模型输出层面的安全问题,那么框架很可能不是最重要的变量。
在这个层面上,真正值得投入资源的是:
第一,扩大攻击覆盖面。因为攻击类型解释了最大的安全差异。
第二,认真评估模型。不同模型本身仍然存在明显差异。
第三,审计 Adapter。确保所谓的“框架差异”不是 Prompt Template、Role 或 System Message 偷偷发生了变化。
第四,把评测继续向 Agent Runtime 延伸。真正的 Agent 风险越来越多发生在:工具、权限、状态、记忆、身份和委托关系中。
这也是 Agent 安全研究正在发生的一次明显迁移:
从“模型会不会说错话”,走向“系统会不会做错事”。
写在最后
AgentPort-Bench 最值得关注的地方,并不是它给七个 Agent 框架排出了一个安全榜单。
恰恰相反。
它发现:
在严格控制变量之后,框架本身几乎排不上号。
真正主导安全结果的是:
你遭遇了什么攻击,其次才是用了什么模型。
而很多看起来属于“框架”的差异,可能只是因为框架在背后偷偷改写了 Prompt、角色或上下文。
这给 Agent 安全评测留下了一个很重要的方法论提醒:
在比较一个系统更安全还是更危险之前,首先要确认我们比较的真的是同一个东西。
但这也恰恰意味着,AgentPort-Bench 并不是这个问题的终点。
当 Agent 真正开始调用工具、持有权限、维护长期记忆、相互委托任务之后,安全问题就不再只是模型输出是否安全。
到了那时,我们真正需要回答的问题将变成:
当模型开始行动,什么才是真正决定 Agent 安全的变量?
而这可能才是下一代 Agent 安全 Benchmark 真正需要解决的问题。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
