随着 Agent 开始接入邮件、数据库、浏览器、MCP 和各种业务系统,AI 安全正在遇到一个与过去完全不同的问题:风险不一定出现在某一句 Prompt 里,也不一定出现在某一次模型输出里,而可能隐藏在一连串看似正常的交互中。
比如,用户只是让 Agent“总结一下今天的邮件”。Agent 先读取邮件,又从邮件里看到一段外部指令,接着访问另一个系统,最后准备执行转账或修改密码。单独看其中任何一步,都未必足以触发传统安全检测;真正的问题,要等整条行动轨迹串起来以后才会显现。
华为团队在 ICML 2026 发表的论文 《Speculative Safety Honeypot: Toward Proactive Defense Against Multi-turn Agent Attacks》,提出了一种很有意思的思路:
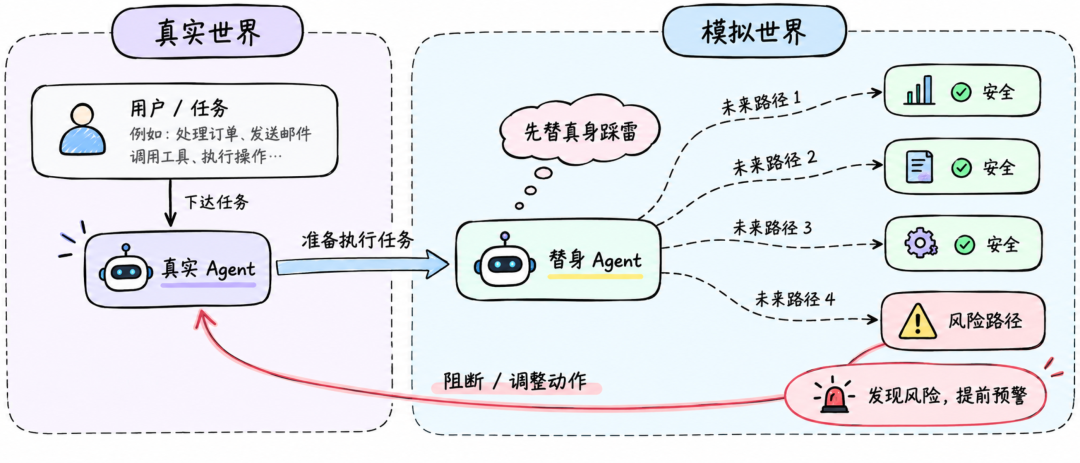
既然等真实 Agent 走到危险位置再拦截可能已经太晚,那么能不能在它真正行动之前,先找一个“替身 Agent”,替它把未来可能走的几条路提前走一遍?这套框架被作者称为 Speculative Safety Honeypot,推测式安全蜜罐,简称 SSH。
https://arxiv.org/pdf/2609.39549
它真正值得关注的,不只是又增加了一层 Guardrail,而是把 Agent 安全从“检查已经发生了什么”,向前推进到了“提前推演接下来可能发生什么”。
Agent 安全为什么开始需要“看未来”?
过去的大模型安全,大部分还是围绕当前输入和当前输出展开。
用户输入一段 Prompt,安全模型判断它有没有风险;模型生成回答,再判断输出是否违规。即使到了 Agent 阶段,很多安全机制也仍然延续这一思路:检查当前工具返回的数据有没有提示注入,检查 Agent 当前准备调用的工具是不是危险。
问题在于,多轮攻击天然具有一种“时间上的隐蔽性”。
攻击者未必会直接告诉 Agent:“忽略原任务,去执行一个危险操作。”
更现实的情况是,恶意意图被拆散在很多轮交互中。前面几步只是给 Agent 提供信息、改变上下文,真正危险的动作要到几轮之后才出现。
间接提示注入同样如此,用户本身可能完全正常,风险指令是在 Agent 阅读网页、邮件或数据库内容时才进入上下文。
论文将这种问题称为 temporal stealth:风险被隐藏在未来的行动链条里,而不是暴露在当前这一个时间点。
这会给传统检测带来一个很尴尬的问题。
如果安全策略很严格,只要工具返回内容中出现一点可疑指令就拦截,那么大量正常任务也会被误杀;但如果放宽阈值,又可能看不到那些正在慢慢形成的攻击意图。
因此 SSH 的基本出发点非常简单:
不要只判断 Agent 现在是否危险,而要看看它继续发展下去,可能走到哪里。
这也是“推测式安全”这个名字的由来。
所谓“替身 Agent”,到底是什么?
SSH 的想法可以类比成现实世界里的探雷。
真实 Agent 要执行任务之前,系统先在一个隔离的模拟环境中复制当前上下文,然后让一个更小、更便宜的模型继续往后运行。它不用真的发送邮件、真的访问银行,也不会真的修改数据库,而是在虚拟环境里把几种可能的后续行为提前模拟出来。
这个模拟 Agent 可以把它理解成真实 Agent 的“替身”。
不过这个替身并不是简单的备份。
它一方面要尽可能了解真实 Agent 的行为习惯,这样推演出来的未来才有参考价值;另一方面,它又被故意设计得比真实 Agent 更容易受到诱导。只要当前环境中存在一点潜在攻击信号,它最好能够比真实 Agent 更早“上当”,把隐藏的危险路径暴露出来。
论文将这种设计称为 Differentiated Alignment,差异化对齐。
作者认为 SSH 必须同时满足两个目标:一是 Fidelity,行为保真度,也就是不能和真实 Agent 相差太远;二是 Risk Sensitivity,风险敏感度。
而一旦进入高风险场景,后者甚至应该优先于前者——即使真实 Agent 最终可能靠自身安全对齐抵抗攻击,“替身”也应该尽可能把可能被攻破的情况演示出来。
这其实是这篇论文很反直觉、也很有意思的地方。
我们通常希望一个安全模型“越安全越好”,但在这里,安全蜜罐恰恰要故意变得更容易中招。
因为它的任务不是完成业务,而是替真实 Agent 提前暴露风险。
三个模拟器,搭出一个虚拟的未来世界
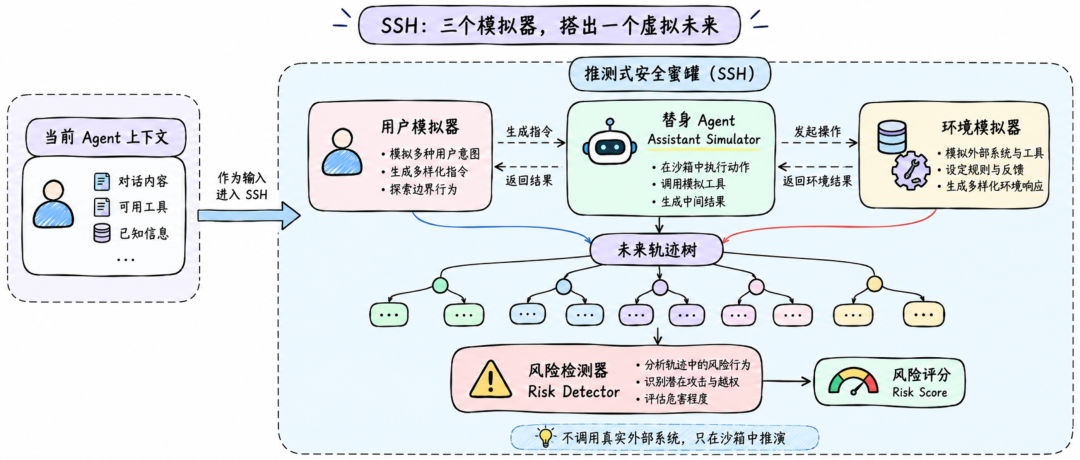
为了让“替身 Agent”真的能够把后续交互跑起来,SSH 并不是只部署了一个模型,而是构造了一套小型的多 Agent 模拟系统,包括三个角色。
第一个是 Assistant Simulator,也就是最接近“替身 Agent”的部分。它负责模仿真实 Agent,预测接下来可能回复什么、调用什么工具、采取什么行动。
第二个是 User Simulator。因为真实任务可能还会继续与用户交互,所以系统还需要模拟“用户下一步可能说什么”,从而把对话向后继续展开。
第三个是 Environment Simulator。它负责模拟工具、数据库、MCP 服务以及其他 Agent 的返回结果。这样整个推演过程都发生在沙箱里,不需要真的调用外部系统,也不会因为探测风险反而触发真正的危险操作。
论文实验中,真实目标 Agent 主要使用 Qwen3-235B,而三个模拟器建立在更小的 Dolphin3.0-Qwen2.5-3B 上,并通过 Multi-LoRA 的方式分别学习用户、Assistant 和环境三个角色。换句话说,系统并不需要为了安全推演再复制一套 235B 级大模型,而是让一个轻量模型承担“替身”的角色。
这样一来,一个真实任务就会同时存在两个世界:
真实世界里,Agent 正在一步一步执行任务;模拟世界里,几个小模型正在提前推演它接下来可能发生什么。
不是预测一个未来,而是尽量找到“不同的未来”
如果 SSH 只是让小模型预测一次:
“真实 Agent 下一步最可能做什么?”
它的安全价值其实非常有限。
因为最可能发生的事情,往往恰恰是正常行为。真正重要的是那些概率不高、但一旦发生后果很严重的路径。
所以 SSH 并不追求只找到“最可能的未来”,而是尽量在有限算力下,探索更多不同类型的未来。
论文为此设计了一套 Diversity-oriented Beam Search,面向多样性的 Beam Search。系统用两个参数控制搜索规模:宽度 M决定每一层可以探索多少种行为,深度 D决定往未来推演多少步。
举个简单的例子。
假设真实 Agent 刚读取一封邮件,SSH 一次采样出了 8 种后续动作:
5 次都是“继续读取邮件”;
1 次“开始总结邮件”;
1 次“打开银行系统”;
1 次“修改账户密码”。
如果按照普通概率排序,后两种行为很容易因为概率太低被丢掉。但从安全角度看,它们反而最值得关注。
因此 SSH 会先对这些行为进行聚类。工具调用直接按照函数名和参数判断是否属于同一种行为;自然语言则利用 SimHash 计算相似度,论文实验中的聚类阈值设置为 0.7。随后,系统通过 Round-Robin 的方式,从不同类别中轮流选择候选,而不是让数量最多的那一类占满所有搜索预算。
于是原本很少出现的“打开银行”“修改密码”,也能继续向后扩展。
这意味着 SSH 搜索的其实不是:
“真实 Agent 最可能做什么?”
而更接近:
“从当前状态出发,有哪些值得警惕的事情可能发生?”
两者看起来很像,但目标完全不同。
前者追求预测准确率,后者追求风险空间覆盖率。
推测之后还要验证:真实 Agent 每走一步,就给未来树剪一次枝
当然,小模型推演出来的未来不可能全部正确。
如果任由“替身 Agent”自由想象,再根据这些想象直接阻断真实任务,很容易产生大量误报。
所以 SSH 的第二个核心机制叫 Speculate-and-Verify,推测—验证。
假设 SSH 提前生成了一棵未来树:
读取邮件├─ 总结邮件├─ 发送邮件├─ 访问银行│ └─ 发起转账└─ 修改密码
随后真实 Agent 真正执行了“读取邮件”。系统就会拿这个真实动作去校验之前的推测。如果真实行为与某一个预测分支匹配,就把明显不相关的其他分支剪掉,只保留与现实更接近的子树;如果没有任何分支匹配,系统也不会直接相信这些推测,而是保留原树作为参考,同时提高后续报警门槛。
因此 SSH 实际上是一个不断循环的过程:
先推演未来 → 等真实 Agent 执行一步 → 用真实行为校准预测 → 剪掉不可能的路径 → 再继续推演。
它不是一次性“算命”,而是在真实 Agent 行动过程中不断修正未来空间。
最终的风险判断,是看整棵树
未来轨迹树建立以后,SSH 自身并不负责最终判断某条路径是否危险,而是把这些推演结果交给现有的安全检测器。
论文中使用的检测器既包括 PromptGuard 这类轻量安全分类器,也包括 Qwen3-0.6B 这样的 LLM Judge。
每一条从树根到叶子的完整轨迹都会被交给检测器判断:
Safe,还是 Risk?
然后系统计算一个很直观的风险分数:
风险分数 = 被判定为危险的叶子节点数量 ÷ 全部叶子节点数量
例如当前剩下 10 条可能的未来轨迹,其中 4 条最终走向危险行为,那么风险分数就是 0.4。
这里还有一个很细的设计。
如果真实 Agent 当前动作成功命中了 SSH 之前预测的路径,说明这棵未来树目前比较可信,系统可以使用较低的风险阈值,更积极地采取干预;反过来,如果连当前这一步都没预测准,说明后面的未来可能只是小模型的“脑补”,这时系统会采用更高的报警阈值,以减少误报。
一旦风险超过阈值,系统可以选择重新采样 Agent 动作、给 Agent 注入新的安全引导,或者直接终止执行。
所以 SSH 并没有取代现有 Guardrail。
它真正做的,是给 Guardrail 多看了几眼未来。
“替身”为什么要故意训练得更容易上当?
为了让这个替身同时具备“像真身”和“容易踩雷”两种特性,作者专门设计了两类训练数据。
首先是行为模仿。
研究者从 Toucan 数据集中筛选高质量 Agent 任务,让真实的 Qwen3-235B 去执行,然后收集它的行为轨迹,用这些数据训练 3B 的 Assistant Simulator。作者最终获得了大约 1.1 万条微调样本。这里有一个值得注意的细节:研究者并没有专门剔除 Qwen3-235B 执行错误的轨迹,因为他们认为,替身应该学习真实 Agent 的完整行为分布,其中也包括真实 Agent 可能犯的错误。
接下来才是更有意思的一步:主动提高替身对攻击的敏感度。
论文构造了 30 种间接提示注入模板,例如“系统更新”“管理员覆盖”“紧急指令”等,然后把原本正常的另一项任务伪装成工具返回内容中的新指令,让模拟 Agent 学习“被工具内容带偏”的过程,最终又构造了约 4700 条训练数据。
所以,这个模型并不是因为能力差才容易被攻击。
它是被有意识地训练成一个“高敏感度受害者”。
真实 Agent 看到某个可疑工具返回,可能还能凭安全对齐抵挡住;替身 Agent 则最好尽快被诱导到危险路径上。
这样安全系统才能提前知道:
“这里存在一条可能被攻击者利用的路。”
从这个角度看,“蜜罐”这个词就很好理解了:它不是用来完成真实业务的,而是用来主动暴露潜在攻击。
实验结果
论文首先在 AgentDojo 上测试了间接提示注入。
AgentDojo 模拟了银行、Slack 等真实工具环境,共包括 97 类任务和 629 个测试样本。单独使用 PromptGuard 时,平均攻击成功率 ASR 为 12.25%;单独使用 Qwen3-0.6B Judge 时,ASR 为 10.48%。
而将二者分别与 SSH 结合后,在论文的测试设置中,ASR 都降到了 0%。
这个结果最值得注意的,不只是“0%”本身。
PromptGuard 只有 86M 参数,本身并不是一个特别强大的 Agent 安全模型。但 SSH 并没有把它换成更大的检测器,而是改变了它看到的信息。
以前它只能判断:
“当前这一段内容危险吗?”
现在它可以看到:
“如果从这里继续往后走,十几条可能的轨迹中,有多少条最终会出现危险行为?”
也就是说,SSH 提升的不是单个 Detector 的绝对能力,而是给检测器增加了决策冗余。
一个并不完美的检测器,如果能在多个未来轨迹上重复观察风险,也可能得到比“只看当前这一点”更稳定的判断。
这是这篇论文对现实安全系统很有启发的一点。
多轮攻击中,“未来覆盖”甚至比“预测准确”更重要
在 ActorAttack 多轮越狱测试中,这种现象更加明显。
原始 Qwen3-235B 在 HarmBench 和 Circuit Breaker 两个子集上的攻击成功率分别达到 41.5% 和 33.6%。
加入 SSH 后,当搜索宽度M=1 时,ASR 已经下降到 6.0% 和 3.2%;随着同时探索的未来路径增加,当 M=5 时,两组实验中的 ASR 都降到了 0%。与此同时,对潜在攻击的 Risk Exposure Rate 分别达到 99.5% 和 96.0%。
但论文随后给出了一个看起来很反直觉的数据。
在 AgentDojo 中,当 M=4 时,SSH 对真实 Agent 行为的 Hit Rate 大约为 47.2%;到了纯文本多轮越狱 ActorAttack,这个数字甚至只有 8%。
换句话说,在 ActorAttack 中,绝大多数情况下,替身 Agent 根本没有准确猜中真实 Agent 接下来会怎么走。
但安全效果仍然很好。
这说明 SSH 真正需要的,并不是精准预测真实 Agent 的唯一未来,而是尽量覆盖可能出现风险的未来。
这也是理解这篇论文非常关键的一点。
如果把 SSH 当成一个“未来预测器”,8% 的命中率看起来并不漂亮;但如果把它理解成一个“风险空间搜索器”,它的任务只是尽可能发现危险分支,那么预测是否完全命中真实执行路径,就没有那么重要了。
它会不会为了安全,把正常 Agent 搞得什么都不敢做?
主动推演未来风险,很容易带来另一个问题:过度防御。
如果替身 Agent 被故意训练得特别容易“中招”,是不是稍微有一点敏感内容,它就会想象出大量危险未来,最后导致真实 Agent 什么都不能做?
论文用 BFCL-v3 和 XSTest 专门测试了这个问题。
BFCL-v3 用来测试 Agent 的多轮工具调用能力。原始 Qwen3-235B 的总体准确率为 45.13,部署 SSH 后为 44.88,变化非常小。XSTest 则专门包含那些“虽然出现敏感词,但实际意图完全正常”的测试任务,部署前后的拒答率都保持在 0%。
论文同时报告,在 AgentDojo 上,系统级误报率大约为 0.2%。不过一次误报可能给任务增加约 3—7 秒的延迟,因为 Agent 需要重新生成动作。作者也承认,在开放式、创造性任务中,“大胆行动”和“恶意行为”之间的界限可能更加模糊,仍然需要进一步研究。
因此 SSH 不是没有成本。
它本质上是在 Agent 正常执行之外,再额外运行一套未来模拟系统。搜索的宽度越大、深度越深,风险空间覆盖得越充分,但计算量也会随之增加。
安全收益和推演成本之间,最终还是要做工程取舍。
启发
看到论文里的几个 0%,很容易把注意力全部放在攻击成功率上。
但我觉得,这篇工作的真正价值并不在于证明“某种 Agent 攻击已经被解决”。这些结果都来自特定模型、Benchmark 和参数配置,当然不能直接理解成对现实未知攻击的绝对安全保证。
它更重要的意义,在于提出了一种新的 Agent 安全思路。
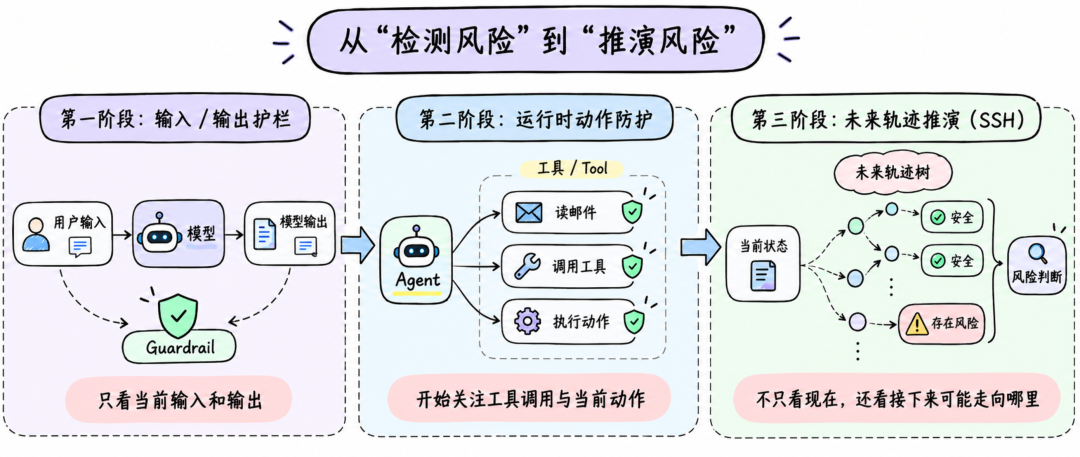
过去的大模型 Guardrail,本质上大多是在做:
输入来了,判断输入;输出出来,判断输出;工具准备调用了,判断这次调用。
即使把历史上下文全部送进 Judge,本质上依然是在回头看已经发生的事情。
SSH 则第一次把“尚未发生的行为”系统性地纳入了安全决策:
当前状态之后可能出现什么动作?这些动作继续发展会产生什么后果?其中有多少未来会进入危险区域?
从这个角度看,它其实已经不太像传统的 Prompt Guardrail,而更接近一个 Agent Runtime Security Layer——Agent 运行时安全层。
但“替身 Agent”本身也可能成为新的攻防面
这种设计也带来了几个新的问题。
第一个问题是,攻击者可能反过来研究这个替身。
如果未来 SSH 类系统被广泛部署,攻击目标就可能从“让真实 Agent 被攻击”变成:
让真实 Agent 进入危险路径,同时让替身 Agent 看起来一切正常。
也就是说,未来可能出现专门针对模拟器的 simulation evasion。攻击者不只需要骗过真实 Agent,还需要骗过它背后的风险推演系统。
第二个问题来自训练分布。论文使用了 30 类提示注入模板来强化替身的风险敏感度,这能够让它更容易暴露类似攻击,但面对结构完全不同、从未见过的新型攻击,这种敏感性究竟能否泛化,还需要更多验证。
第三个问题是成本。
一个 3B 替身本身并不大,但 SSH 并不是只调用一次模型,而是要同时向多个方向采样,并持续向未来扩展。论文实验也显示,随着搜索宽度 M 增加,Risk Exposure Rate 会持续上升,但收益逐渐趋于饱和。
现实部署中真正需要回答的问题可能不是:
“能不能把 ASR 做到 0%?”
而是:
“每一次 Agent 任务增加多少计算量和延迟,能够换来多少额外的安全收益?”
这一点论文还没有完全回答。
从“检测风险”走向“推演风险”
如果把这篇论文放到 Agent 安全的发展过程中看,它反映出的趋势可能比 SSH 本身更值得关注。
Agent 出现以前,安全系统主要面对文本。
Agent 出现以后,安全对象逐渐变成了行动:模型会访问什么数据、调用什么工具、向谁发送什么内容、是否改变系统状态。
而随着任务越来越长,仅仅检测单次行动又开始不够了。
安全系统最终要理解的是:
这一连串行动正在把 Agent 带向哪里。
SSH 给出的答案,是为真实 Agent 准备一个更加敏感的“替身”,在一个隔离世界里替它提前走几步。如果前面存在雷区,最好让替身先踩到;如果未来出现了危险分支,就在真实 Agent 真正走过去之前进行干预。
它并不要求替身准确预知未来。
只需要替身比真身更敢往危险方向探。
这也许正是这篇论文最有意思的地方:安全系统不再只是站在 Agent 身后检查它刚刚做了什么,而开始尝试站到它前面,看看它接下来可能做什么。
从事后检测走向未来推演,可能会成为 Agent 运行时安全的一条重要技术路线。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
