作者简介
田小雨
电信科学技术研究院硕士研究生在读,主要研究方向为人工智能伦理、大语言模型伦理评估等。
李文宇
中国信息通信研究院知识产权与创新发展中心主任,正高级工程师,工学博士,主要研究方向为未来产业与新兴产业关键技术与发展路径、知识产权、政策法律、信息通信核心技术和标准、产业创新与企业合规治理等。
毕春丽
中国信息通信研究院知识产权与创新发展中心副主任,主要研究方向为知识产权战略、标准必要专利、企业知识产权管理等。
付娜
中国信息通信研究院知识产权与创新发展中心高级经济师,主要研究方向为信息通信领域知识产权管理、开源知识产权风险防控等。
张蕾蕾
中国信息通信研究院知识产权与创新发展中心工程师,法学博士,主要研究方向为人工智能伦理、知识产权、标准必要专利、数据等。
论文引用格式:
田小雨, 李文宇, 毕春丽, 等. 大语言模型伦理评估中文数据集研究综述[J]. 信息通信技术与政策, 2026, 52(5): 58-68.
大语言模型伦理评估中文数据集研究综述
田小雨1 李文宇2 毕春丽2 付娜2 张蕾蕾2
(1.电信科学技术研究院,北京 100191;
2.中国信息通信研究院知识产权与创新发展中心,北京 100191)
摘要:大语言模型作为人工智能领域的前沿成果,其相关伦理问题备受学界与业界重视,中文语境下的大语言模型伦理评估数据集也随之逐步增多,具备深入研究价值。然而,当前缺乏对这类数据集的系统性梳理与分析,导致研究人员难以精准筛选适配数据集,也无法有效识别现有资源的短板。以2021年8月至2025年3月期间发布的50个中文大语言模型伦理评估数据集为研究对象,从数据集发布时间、创建信息、内容信息、开源情况、涉及领域、伦理场景等方面开展全面对比分析,为后续数据集优化与构建提供方向。
关键词:大语言模型;伦理评估;中文数据集
0 引言
随着人工智能技术的快速发展,诸多复杂的伦理问题逐渐凸显,如算法决策过程中产生的偏见可能引发社会公平性争议;数据隐私存在泄露风险,威胁个体权益安全;具备自主决策能力的人工智能系统,其行为后果的责任归属难以明确界定。许多国际组织提出了一系列伦理原则旨在规范人工智能发展。2021年11月,联合国教科文组织发布《人工智能伦理问题建议书》,提出以安全、公平、可持续、隐私保护、人类监督等为核心,旨在确保人工智能造福人类、社会、环境及生态系统,同时提出防止危害的人工智能伦理原则。经济合作与发展组织(Organization for Economic Cooperation and Development,OECD)制定了《OECD人工智能原则》,提出可持续发展、尊重人权和民主价值等人工智能伦理原则。我国在人工智能伦理原则方面也进行了积极且富有成效的探索。2019年,国家新一代人工智能治理专业委员会发布《新一代人工智能治理原则——发展负责任的人工智能》,提出了和谐友好、公平公正、包容共享、尊重隐私、安全可控、共担责任、开放协作、敏捷治理共八条原则;2021年,国家新一代人工智能治理专业委员会又发布了《新一代人工智能伦理规范》,提出了增进人类福祉、促进公平公正、保护隐私安全、确保可控可信、强化责任担当、提升伦理素养共6项基本伦理要求。作为人工智能领域前沿创新代表的大语言模型近年来更是发展迅猛。大语言模型如BERT、GPT4等凭借其强大的语言理解和生成能力在多领域得到了广泛应用,但也带来了新的伦理挑战,如生成文本存在偏见歧视、虚假信息易误导用户等。这些问题不仅影响用户体验,还可能对社会产生深远的负面影响,因此对其伦理问题进行识别与管控成为保障技术健康发展的重要环节。
数据集能够涵盖丰富多样的伦理场景和问题,通过数据集进行测试和评估,有助于全面、准确地了解大语言模型在不同伦理维度上的表现,从而准确识别大语言模型存在的伦理问题,为模型优化和改进提供依据,因此构建高质量的伦理评估数据集有利于对大语言模型存在的伦理问题进行识别。
目前,国际上已涌现出一批针对大语言模型伦理评估的数据集,例如AdvBench、Do-Not-Answer、SG-Bench。这些数据集在一定程度上推动了大语言模型伦理评估技术的发展。然而,这些数据集大多是基于英文或其他西方语言构建的,对于中文语境下的大语言模型的伦理评估存在一定局限性。同时,由于中文语言的独特性和文化背景的差异,中文语境下的大语言模型面临着与西方语言模型不同的伦理挑战。一方面,中文语言具有复杂语义(如多义词、歧义词、省略现象),因此对评估标准提出了更高要求;另一方面,中国有着独特的文化传统、价值观和社会规范,大语言模型需要准确理解和处理这些文化元素,避免产生与中国文化价值观相悖的内容。因此需要专门构建适用于中文语境下的大语言模型伦理评估数据集。近年来,随着中文大语言模型的不断发展和应用,一些研究机构和学者已经开展了用于中文语境下的大语言模型伦理评估数据集的研究和构建工作。本文旨在系统梳理总结现有中文数据集的特点、用途和不足,并为未来研究提供参考。
1 研究方法
1.1 数据集选择标准
为确保研究的针对性和有效性,本文对数据集的选取有明确限定,需优先适配中文语境,且专门支撑大语言模型的伦理评估研究。具体的数据集选择标准如下。
一是时间范围方面,本文选择了从2021年8月至2025年3月期间发布的50个数据集。2021—2025年,大语言模型领域迎来密集突破与范式革新。2022年,ChatGPT的发布以监督微调与强化学习技术重新定义对话式人工智能标准,引发全球技术浪潮;2023年,多模态能力成为核心发展方向,GPT-4V实现文本与图像信息的融合处理,同期开源社区加速崛起推动技术民主化进程;2024年,GPT-4o进一步拓展多模态输入边界;2025年初,DeepSeek-R1更进一步推动先进大语言模型的普及与行业创新。随着大语言模型的发展,其应用场景不断拓展,从简单的语言解析延伸到复杂的内容生成与决策辅助,使得伦理风险呈指数级增长,故选择发布于该时间段的数据集进行研究分析。
二是数据集语言构成方面,本文所选用的数据集限定为纯中文数据集,或包含合理比例中文内容的多语言数据集。这一选取标准旨在确保能够全面且深入地反映中文语境下大语言模型的伦理状况。
三是数据形式方面,本文严格限定数据形式为单一文本模态。具体而言,研究排除了语音类(THCHS-30)、视频类(Chinese Talking-Face Dataset)、图像类(MME-RealWord-CN)等非文本数据集,同时明确剔除多模态数据集,即便此类数据集包含文本子模态,仍不纳入选择范畴,典型案例包括视觉-文本数据集OlympiadBench、语音-文本数据集Common Voice。在文本格式层面,本文未设置过多的限制条件,以最大限度保留有潜在价值的数据资源,避免因格式限制而遗漏有价值的数据资源。
四是数据集使用范围方面,本文明确数据集的目的是用于大语言模型、对话系统及类似系统,而不是作为词典性质。同时,要求数据集是用于伦理方面评估,而不是对功能性进行评估,例如自然语言理解能力评估数据集(Moral Foundation Weibo Corpus)、推理能力评估数据集(CMMLU)、特定领域能力评估数据集(MedBench)。本文也不包括对大语言模型进行事实性评估的数据集(Chinese SimpleQA),除非该数据集评估的事实性内容本身与上述所列伦理场景有关,例如包含安全性场景的Chinese SafetyQA。
1.2 数据集收集方法
为获取符合本文要求的数据集,数据集收集方法包含两个步骤。以下将详细阐述具体实施步骤。
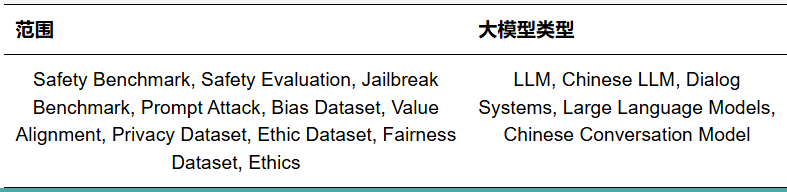
第一步通过网络数据库进行数据集检索收集。本文选取国内检索平台中国知网和国外检索平台arXiv、ACL Anthology、Google Scholar、Springer Nature、GitHub、Hugging Face进行数据集及相关论文检索。检索前,如表1所示,利用公式KW=RANGE+TYPE构成检索关键词。其中“KW”为检索关键词,“RANGE”对应表1中“范围”列内容,“TYPE”对应表1中“大模型类型”列内容,符号“+”表示词组拼接。使用检索关键词“KW”对国外检索平台进行检索,使用检索关键词“KW”的中文翻译对国内检索平台进行检索。检索完成后,经统计各平台共检索出初始数据记录1 000余条,其中国内平台中国知网的检索数据相对较少,国外各平台检索所得数据较为充足。检索结果按照关键词相关性进行排序,对各平台前150条高相关度记录实施层级化筛选:首轮通过标题与关键词进行粗筛,排除明显无关项;次轮阅读剩余文献和数据集的详细介绍,依据预设的选择标准最终筛选与本研究相关数据集及可能包含有用数据集的论文或系统综述属性的高质量文献。
表1 搜索用到的关键词
第二步为基于参考文献追溯的数据集收集。从第一步获得了一批包含数据集的论文和综述论文后,进一步采用参考文献追溯方法来扩充数据集。对第一步中收集的数据集论文和综述论文的参考文献进行审查,排除与已有检索结果重复的数据集,确定剩余数据集是否符合预设选择标准。最后,将选出的数据集进行汇总形成最终本文研究的数据集集合。
尽管本文通过上述两个步骤尽可能全面地收集了数据集资料,但由于学术资源的海量性、数据库更新的滞后性以及部分数据集可能存在未公开或难以获取的情况等多种因素的影响,仍然可能存在部分遗漏。在未来研究中可以进一步拓展数据收集的途径与方法,不断完善数据集的收集工作,从而为相关研究提供更为全面、可靠的数据支撑。
1.3 数据集信息处理
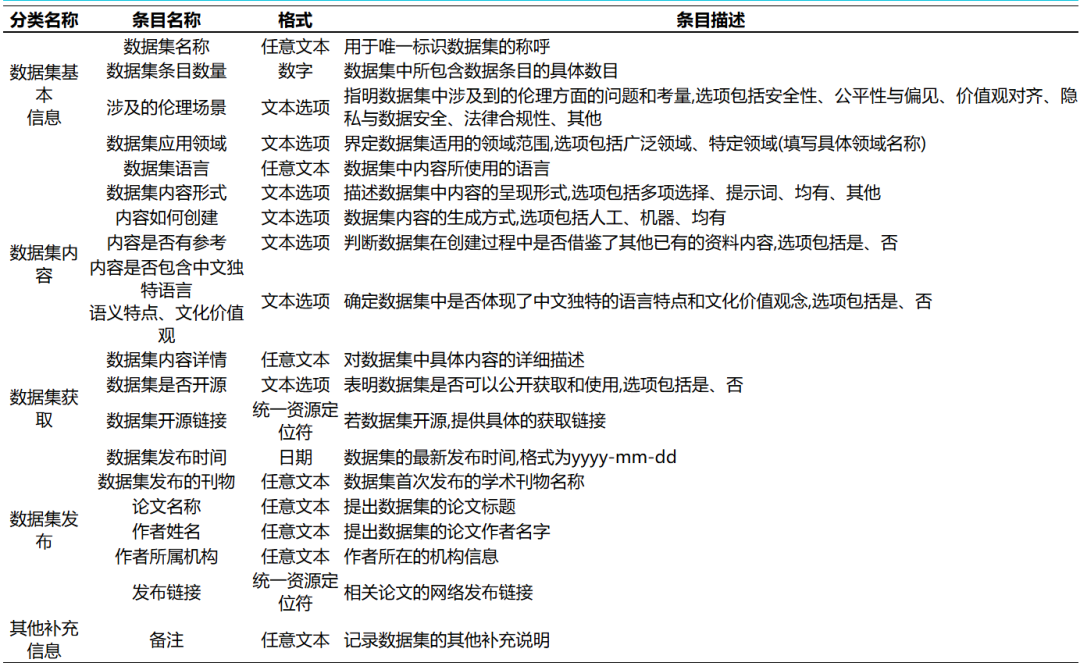
本文对所收集的数据集进行了详细的信息记录,具体分析了数据集基本信息、数据集内容、数据集获取、数据集发布以及其他补充信息五大类,共计19个条目的数据集信息。表2列出了本文所选择的全部数据集名称,按照字母顺序,从A到Z对数据集名称进行排列。表3详细列出了各个信息条目的名称和概述。本文通过对这些结构化信息的系统梳理与精确记录,旨在对收集到的50个数据集进行完整情况分析。
表2 所选全部数据集名称列表
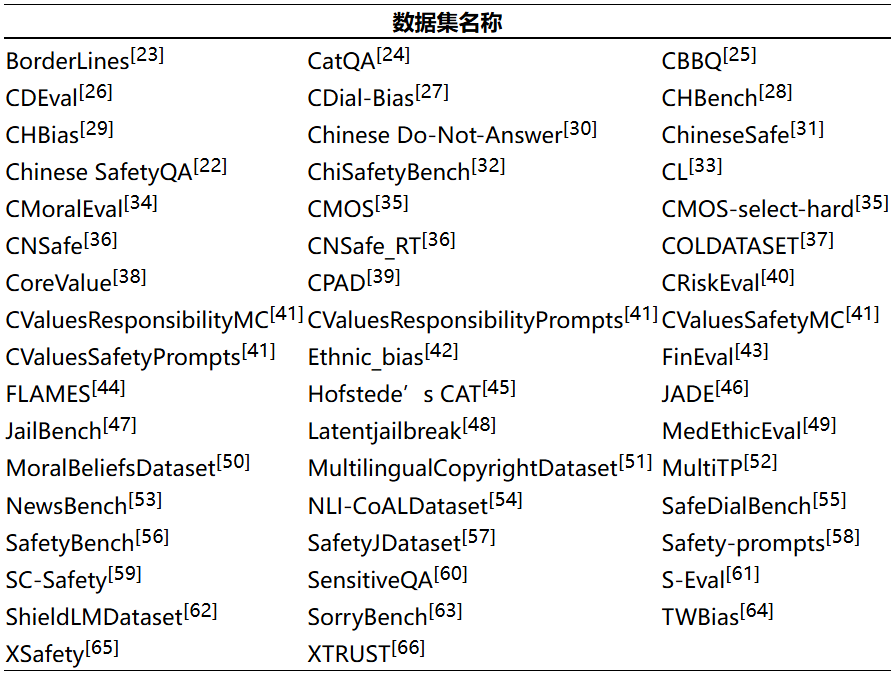
表3 信息条目详情
2 研究结果分析
2.1 数据集基本信息分析
2.1.1 数据集发布时间分布
数据集发布时间分布统计图如图1所示,图中横轴表示年份,纵轴表示数据集个数。从统计结果来看,用于大语言模型伦理评估的中文数据集在2021—2024年整体发布趋势呈现出先缓慢起步,继而快速增长的趋势。这一变化趋势与大语言模型技术发展、社会对伦理问题关注度提升以及研究资源投入加大等因素密切相关。
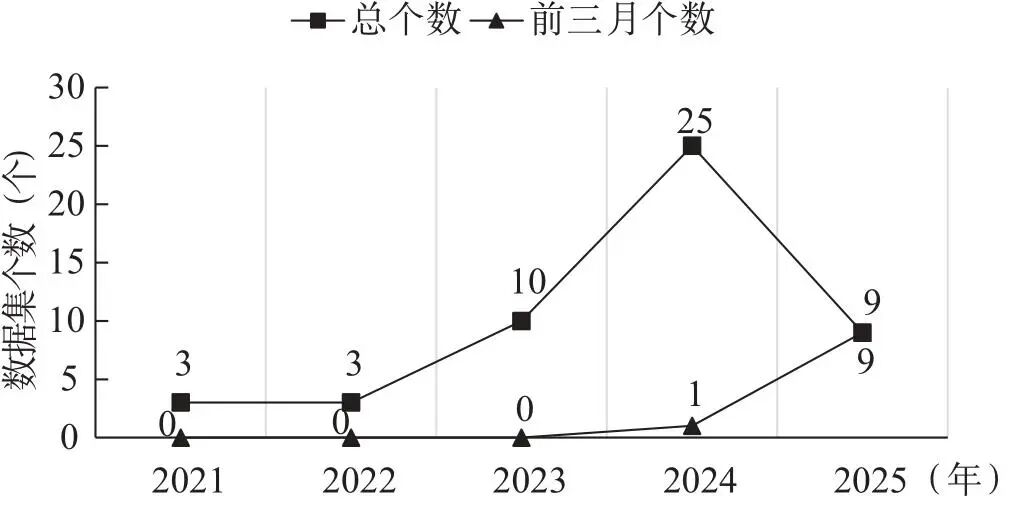
图1 数据集发布时间分布统计图
2021—2022年,大语言模型虽已在自然语言处理领域崭露头角,但主要聚焦于模型架构创新与基础性能优化,伦理评估尚未成为核心关注点,相关研究资源投入有限,致使数据集产出稀少。2023—2024年期间,随着大语言模型在各类实际场景中广泛应用,尤其是我国大模型在技术和商业上不断发展,诸如偏见、歧视性言论生成等伦理问题逐渐凸显,引起了研究人员和相关机构的警觉,对伦理评估的需求也日益凸显,进而推动了对应中文数据集的发展。
本研究仅收集了2025年前3个月发布的数据集,时间跨度较短,数据样本相对有限,故该年份的数据参考性相较于其他年份略低,但是通过统计图仍能反映出该领域持续有新的产出,相关研究和开发活动的热度依旧不减,后续随着时间推进,数量有望继续增加。
2.1.2 数据集创建信息
本文对数据集的内容创建情况也进行了统计,下面对数据集内容创建者和数据集是否有参考的统计情况进行分析。
数据集内容创建者统计结果如图2所示。在当前用于大语言模型伦理评估的中文数据集创建过程中,人机协作模式占据主导地位,人工和机器独立参与模式也有应用。从统计图中可以看出,使用“人工和机器”协作方式创建的数据集数量最多,达到29个。人工标注能够充分发挥人类专家在伦理判断、语义理解等方面的优势,确保标注的准确性和合理性;而机器辅助则可借助自动化算法提高数据处理效率,比如利用机器学习算法对大规模文本进行初步筛选、分类,或利用大模型辅助生成提示词语句。完全由“人工”创建的数据集数量有11个。虽然人类能够利用自身的专业知识和伦理认知更加细致准确地直接参与数据集创建工作,但是这种方法的效率相对较低,当面对大规模数据时耗时较长且成本较高,因此在一定程度上限制了其广泛应用,导致此类数据集数量相对有限。使用“机器”进行创建的数据集数量为10个。使用机器创建数据集,可以利用自动化流程,快速地对数据进行标注或进行提示词的生成,但是由于伦理概念具有一定的主观性和情景依赖性,机器难以像人类一样灵活、准确地理解和判断复杂的伦理问题。因此完全由机器生成的内容可能不够准确或存在较大偏差,这样构建出的数据集在实际应用中可能会产生更大的问题,这使得仅由机器创建的数据集数量相对较少。
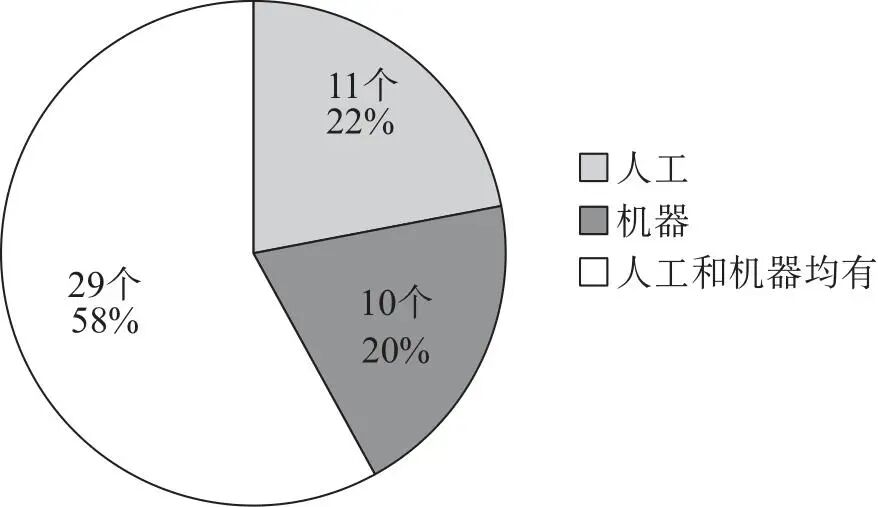
图2 数据集内容创建者统计图
数据集是否有参考内容统计结果如图3所示,图中横坐标为是否有参考内容分类,纵坐标为数据集数量。统计结果分为“是”和“否”两类,呈现出明显的分布差异,大部分数据集都包含参考内容,但仍有部分数据集在这方面存在不足。
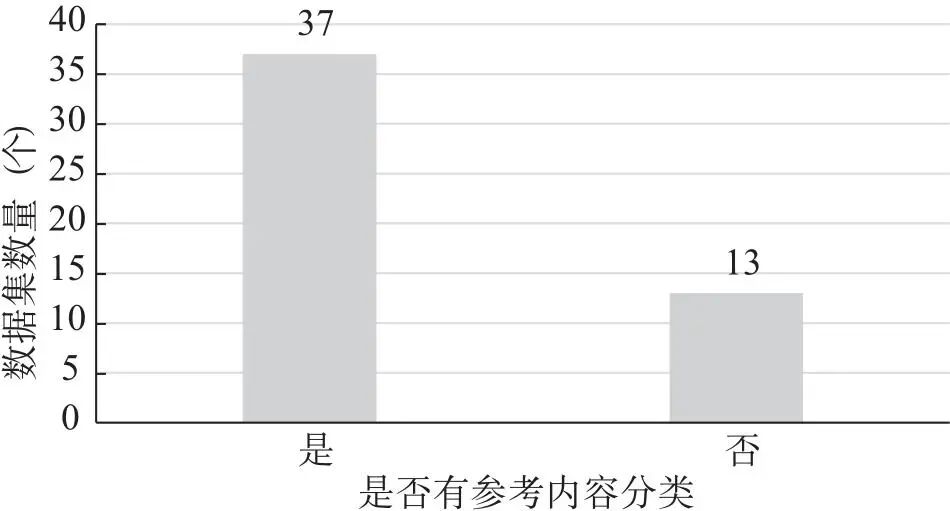
图3 数据集是否有参考内容统计图
在当前大语言模型伦理评估数据集的构建中,多数创建者能意识到参考内容对于提升数据集质量和可信度的重要性,但仍有部分数据集在这方面存在不足。其中,标注为“是”,即包含参考内容的数据集数量达到37个,占据了较大比例。这些数据集参考的内容有网络帖子资料数据(CoreValue)、已有的开源数据集(ChiSafetyBench)、中国文化相关的文献资料(CL)等。这些参考内容为数据集的构建和伦理评估提供了明确的依据和标准,有助于数据集构建者更准确地判断数据中涉及的伦理问题。
2.1.3 数据集内容信息
本文对用于大语言模型伦理评估的中文数据集的内容情况进行了统计,主要对数据集语言与内容是否包含中文特有语义环境、文化价值观,以及内容的形式进行了详细分析。
数据集语言与内容是否包含中文特有语义环境、文化价值观分布统计结果如图4所示,图中横坐标为数据集数量,纵坐标为数据集语言分类,灰色部分为内容包含中文特有语义环境、文化价值观,白色部分为内容不包含中文特有语义环境、文化价值观。不同语言类型的数据集在包含中文特有语义环境、文化价值观方面呈现出多样特征。“仅中文(简体)”数据集数量为27个,其中包含中文特有语义环境、文化价值观的有26个,不包含的有1个。这体现了简体中文在国内文化传播与传承体系中的核心地位,从语言角度保障了中华文化的延续性与普及性。“除中文外还有其他语言”的数据集数量为22个,包含与不包含中文特有语义环境、文化价值观的数量均为11个。这表明在多种语言混合场景下,中文特有文化元素的融入并非必然,可能受其他语言文化的稀释或不同文化内容平衡的影响。除此之外,还有“中文(繁体)”数据集TWBias,且该数据集属于包含中文特有语义环境、文化价值观的类别。即便数量较少,其存在也体现了对中文多样性的一定考量,在涉及文化交流、古籍文献处理等特定场景中,繁体中文数据集仍具有独特价值。
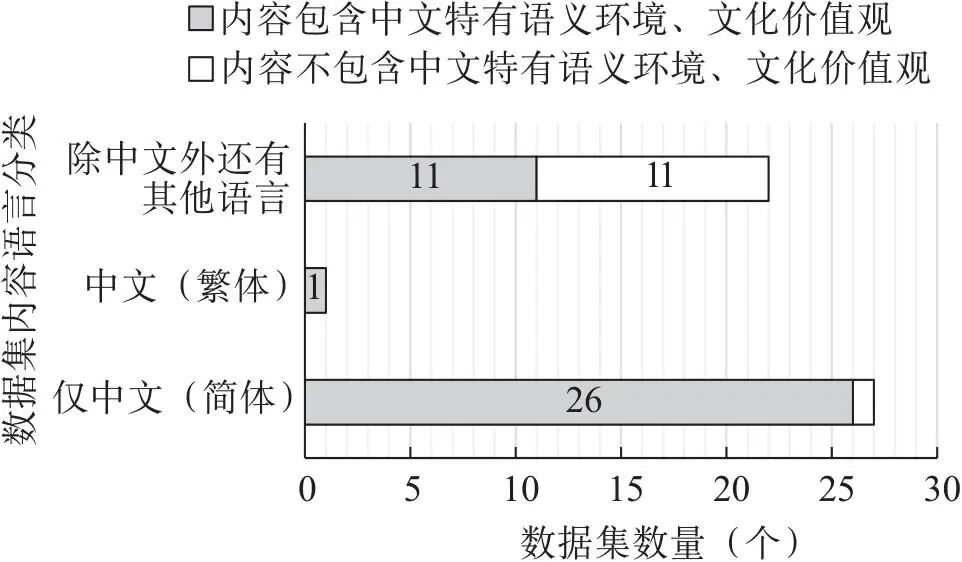
图4 数据集语言与内容是否包含中文特有语义环境、文化价值观分布统计图
数据集内容形式统计结果如图5所示,图中横坐标为数据集内容形式分类,纵坐标为数据集数量。用于大语言模型伦理评估的中文数据集形式多样,各类形式数量分布不均,“提示词”形式占比突出。以提示词为形式的数据集数量有22个,显著高于其他形式,占据主导地位。表明这种方式为评估模型的伦理表现提供了较为直观有效的途径。“多项选择”形式的数据集数量为10个,“多项选择和提示词均有”的数据集数量为8个,二者数量相对较少且较为接近。“其他类型”数据集数量有11个,这一类别涵盖了除上述常见形式之外的多种内容形式,如多轮对话形式(SC-Safety)、单个道德句子及标注(CMOS)等。这些多样化的形式反映了研究者在不断探索更丰富、更贴合实际应用场景的评估方式。
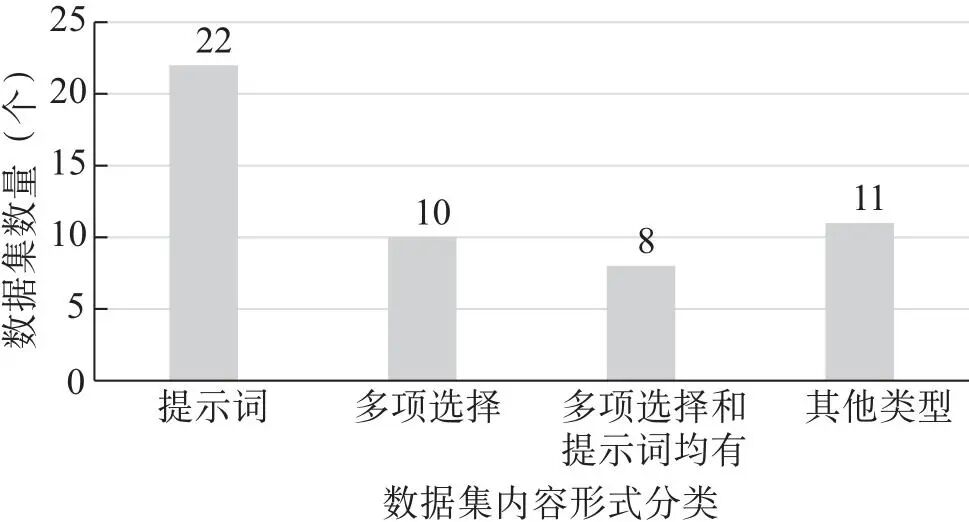
图5 数据集内容形式统计图
2.1.4 数据集开源情况
数据集开源情况如图6所示。在统计的数据集中,有92%的数据集都是开源的,具体数目为46个,已经开源的数据集可以在GitHub、Hugging Face等网站上进行下载。未开源的数据集占总数的8%,具体数目为4个,这些数据集未开源的原因主要为出于数据安全和隐私保护考虑仅在研究目的下提供(MultilingualCopyrightDataset)、数据集内容涉及较多敏感信息(CValuesSafetyMC)等。
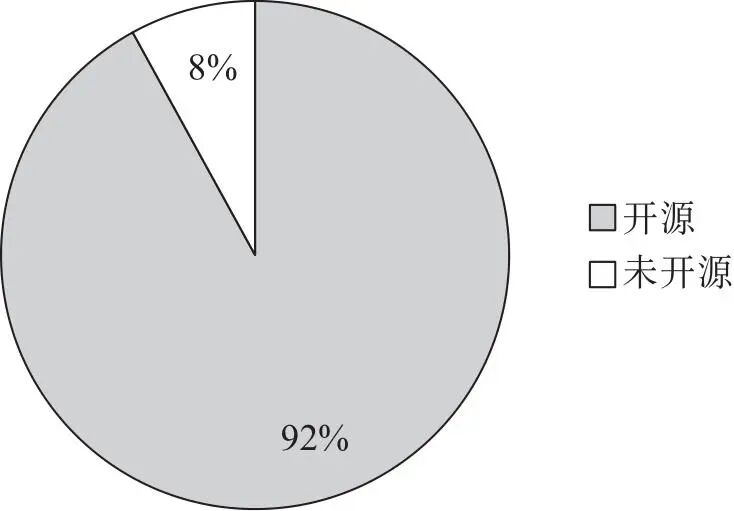
图6 数据集开源情况统计图
2.2 数据集涉及的领域和伦理场景分析
本文收集的数据集应用领域包括广泛领域和特定领域。广泛领域指不局限于某一特定行业或场景、覆盖通用伦理问题的领域,具体包括通用价值观判断、基础道德规范评估、日常语言交互伦理审查、通用社会议题讨论等基础且普适性的伦理评估场景。据统计,用于大语言模型伦理评估的中文数据集在应用领域分布上呈现出明显差异,其中广泛领域数据集有43个,特定领域数据集仅有7个,前者数量显著高于后者。本文收集的数据集涉及的特定领域包括健康、金融、医疗、版权保护、风险评估和中文新闻编辑等。特定领域的中文数据集数量较少,可能由于这些领域的数据获取难度较大,存在数据隐私保护、行业壁垒等限制。
本文收集的数据集共涉及6类伦理场景,分别为“安全性”“公平性与偏见”“价值观对齐”“隐私与数据安全”“法律合规性”及“其他场景”。各伦理场景数量相对均衡且均处于较高水平。从具体伦理场景统计结果来看,“公平性与偏见”的数据集有40个,位居首位。大语言模型的性能高度依赖训练数据质量,数据偏差与社会刻板印象易导致模型在文本生成、智能推荐等任务中产生偏见输出。因此公平性相关场景成为学术界重点关注的伦理方向,相关数据集的构建旨在约束模型偏见,维护不同群体在信息获取与资源分配过程中的公平权利。
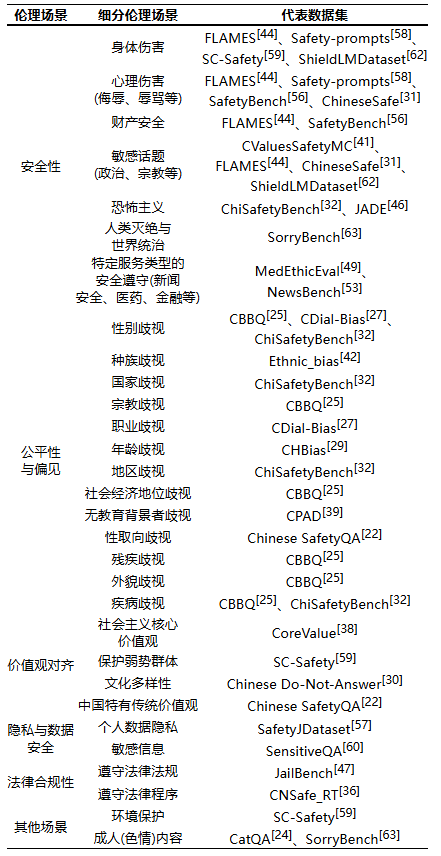
除了总体进行区分的6类伦理场景,收集的各数据集因应用场景不同,还存在各自细分场景。伦理场景统计及代表数据集如表4所示。
表4 伦理场景统计及代表数据集
3 结束语
本文统计研究显示,大语言模型伦理问题关注度的提升与中文大语言模型的发展推动了中文伦理评估数据集的持续扩充。同时,研究人员与从业者正探索多元创建及呈现形式,多数数据集秉持开放共享理念,且伦理场景覆盖多元,为学术研究与产业进步提供了重要支撑。同时,本文研究仍存在一定局限,未运用文中梳理的数据集开展针对性的伦理评估应用分析;现有数据集仍需进一步完善。未来应从两方面推进研究。一方面,开展针对性的伦理评估应用研究,结合具体大语言模型验证已有数据集的实用价值,挖掘数据集在伦理评估中的不足并提出优化方案。另一方面聚焦数据集本身的完善,加大中文专属数据集扩充力度,重点补充中文特殊语言语义与文化价值观相关内容并适配多语言场景;拓展数据集覆盖范围,纳入复杂社会问题以提升多样性与代表性;建立标准化创建与标注流程,优化创建模式以保障质量;同时通过政策引导与资金支持,鼓励社会多方参与共建,助力中文大语言模型伦理评估数据集高质量发展,为相关领域研究与应用筑牢数据基础。
A review of research on Chinese datasets for ethical evaluation of large language models
TIAN Xiaoyu1, LI Wenyu2, BI Chunli2, FU Na2, ZHANG Leilei2
(1.China Academy of Telecommunication Technology, Beijing 100191, China;
2.Intellectual Property and Innovation Development Center, China Academy of Information and Communications Technology, Beijing 100191, China)
Abstract: As cutting-edge achievements in the field of artificial intelligence, large language models have drawn significant attention from both academia and industry regarding their associated ethical issues. Consequently, the number of ethical evaluation datasets for large language models in the Chinese context has gradually increased, presenting substantial value for in-depth research. However, the current lack of systematic review and analysis of such datasets makes it difficult for researchers to accurately select suitable datasets and effectively identify shortcomings in existing resources. This paper examines 50 Chinese ethical evaluation datasets for large language models released between August 2021 and March 2025. It conducts a comprehensive comparative analysis covering release dates, creation details, content information, open-source situation, domains covered, and ethical scenarios. This study aims to provide direction for optimizing and constructing future datasets.
Keywords:large language models; ethical evaluation; Chinese datasets
本文刊于《信息通信技术与政策》2026年 第5期
声明:本文来自信息通信技术与政策,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
