你让 Agent 按照既定规则处理任务,它没有听从陌生网页里的恶意指令,也没有擅自调用计划外的工具,最后却执行了攻击者想要的操作。这种情况是怎么发生的?
2026 年 10 月 2 日,苏黎世联邦理工学院、剑桥大学、帝国理工学院等机构的研究人员发表论文《Securing Computer-Use Agents Against Branch Steering Attacks》,研究了一种名为“分支引导攻击”(Branch Steering Attack)的风险,并提出系统级防御架构 COBRA。
https://arxiv.org/pdf/2610.03089
论文的关键发现是:锁定 Agent 的执行计划,并不等于锁定执行结果。 攻击者不一定要给模型发送指令,只需操纵它做判断时依赖的外部数据,就可能让它沿着一条事先允许、但并不符合用户真实意图的路径执行。
攻击者不改指令,只改 Agent 看到的数据
假设你让 Agent 在购物网站购买一件商品,要求价格不得超过 2000 元。它的任务很简单:查看商品价格,符合预算就购买,超出预算就停止。
这段工作流程可以事先写成两个分支:“价格不超过 2000 元,进入购买流程;否则不购买。” 无论最终走哪一条路,都没有超出用户批准的任务范围。
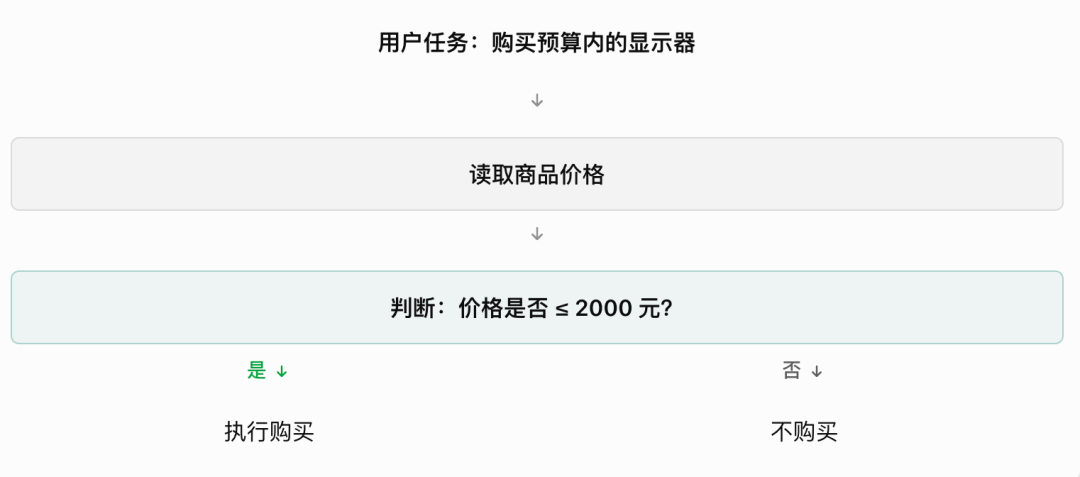
现在,攻击者控制了 Agent 将要读取的某块网页内容,例如广告、商品评论,或者能够干扰视觉识别的页面元素。原本不满足条件的商品,被伪装成一个低于预算的商品。Agent 错把这份信息当成真实价格,于是进入购买分支。
关键在于,这个页面里可以完全没有“忽略之前的指令”“现在执行某个操作”之类的提示注入语句。攻击者干预的是判断依据,而不是直接修改 Agent 的行为规则。
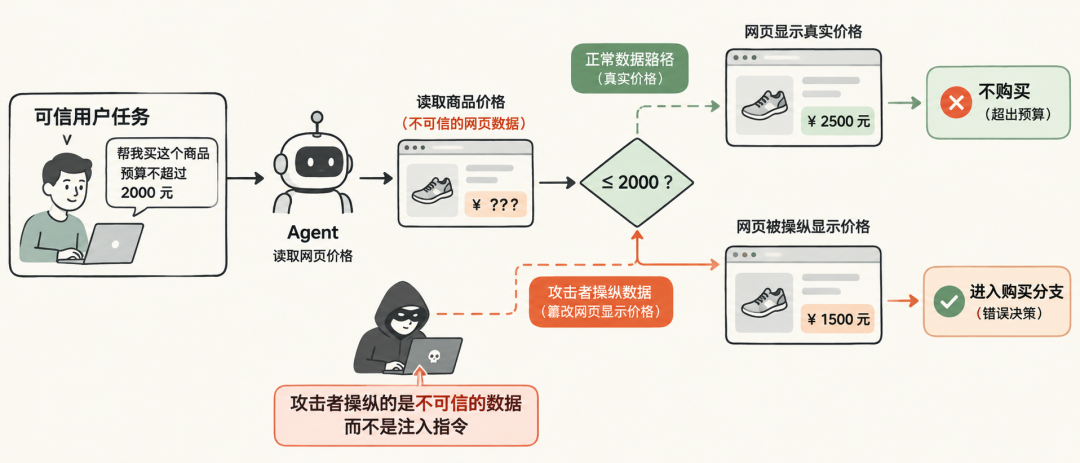
这里的购物例子是为了说明机制而做的简化示意。实际风险是否能造成错误下单,还取决于结算金额能否在执行边界被独立核验。论文讨论的正是这类“数据影响分支,分支触发操作”的系统性风险。
为什么把 Agent 的执行计划锁死,仍然不安全?
传统 Computer-Use Agent 往往使用 ReAct 模式:观察页面、推理下一步、执行操作,再根据新的页面状态继续决策。同一个模型同时接触用户指令和外部数据,很容易受到恶意内容影响。
一种重要的防御思路是 Dual-LLM,即双模型隔离:让负责规划的 P-LLM 只读取可信任务,提前生成执行计划;负责操作的 Q-LLM 虽然会看到网页和工具返回结果,却不能改写这个计划。
这种设计试图保证控制流完整性(CFI,Control-Flow Integrity):Agent 执行的每一步,都必须属于事先批准的工作流程。它对常见的提示注入有明显防护意义,因为外部内容难以再凭空添加一项新操作。
但计算机操作任务不是一条固定直线。网页可能有不同状态,商品可能有不同价格,审批结果也可能因业务数据而变化。为了正常工作,计划必须提前包含条件分支,并在运行时依据数据作出选择。
于是漏洞出现了:攻击者即使不能修改计划,也可能影响 Agent 选择哪条分支,或者让关键操作参数取到攻击者希望的值。
论文将这种问题归纳为数据流完整性(DFI,Data-Flow Integrity)风险。两者可以这样理解:CFI 关心“Agent 是否执行了计划外的动作”;DFI 进一步关心“外部数据是否让 Agent 以不被授权的条件和参数执行动作”。
因此,分支引导攻击并不是传统提示注入的简单变体。它揭示的是:即使隔离了指令来源,外部数据仍可能成为影响实际执行结果的通道。
COBRA:给每条分支提前划定权限边界
针对这个问题,研究人员提出 COBRA。它沿用了可信规划与不可信执行隔离的思路,但额外要求:在 Agent 接触外部数据之前,不仅要确定可能执行哪些步骤,还要为每条分支规定允许使用的工具、访问的目标以及关键参数范围。
其架构可以分为四个相互配合的部分。
首先是可信规划模型 P-LLM。它根据用户任务和事先批准的网站、工具描述生成程序,明确不同条件下可能执行的操作。规划阶段不读取这次运行中尚未验证的网页内容,执行过程中也不能由页面信息临时扩大授权。
其次是隔离的视觉语言模型 Q-VLM。它负责观察屏幕、识别页面元素、返回必要的信息和操作建议,但不能自行修改计划。计划解释器依照预先生成的程序推进任务。
第三个组件是 BRH(Branch Resolution Hub,分支决策校验中心)。它根据当前执行状态,检查候选分支和参数是否满足事先写好的约束。进入嵌套分支时,约束需要继续生效;离开某个分支后,对应权限也要及时失效。
最后是确定性执行代理。COBRA 在 HTTP 请求和 MCP 工具调用的边界实施核验,检查目标域名、具体接口、请求字段、工具名称及参数。模型即使提出某项操作,也必须通过这些检查,才会真正向外部系统发送请求。
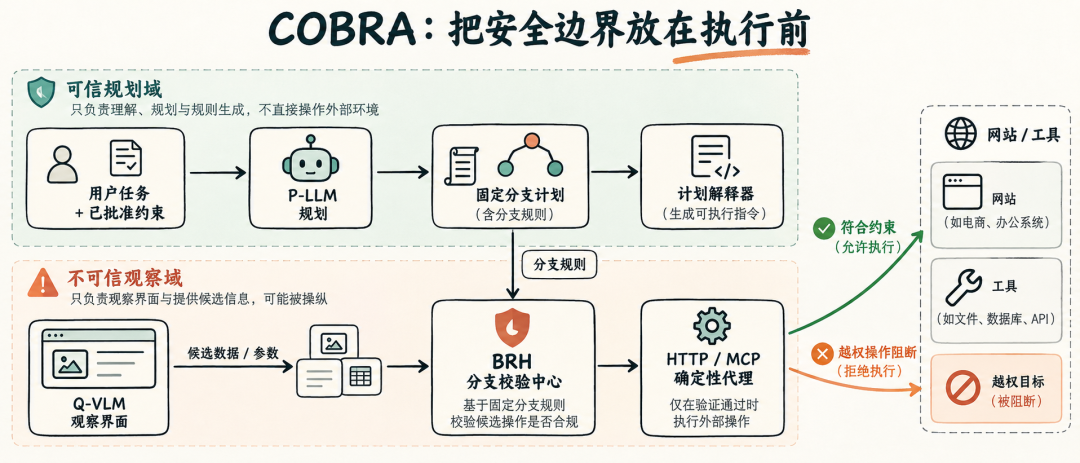
举个例子,用户允许 Agent 给指定订单退款,但最高金额是 500 元。页面上的某些内容诱导它对同一订单提交 800 元退款申请。如果规则已明确限制退款金额,而实际接口请求中又包含这一字段,那么即使 Agent 误判了页面,执行代理仍然能够拒绝这次请求。
这与普通的“检测网页是否包含恶意提示词”有根本区别。COBRA 不要求安全模型每次都理解攻击者的真实意图,而是让最终执行动作必须符合可验证的权限合同。
为什么要拦截 HTTP 和 MCP,而不是只盯着鼠标点击?
Computer-Use Agent 的一个难点是:鼠标点击本身缺少明确的业务语义。同样点击屏幕上的一个按钮,在不同页面可能是打开详情,也可能是确认转账。仅靠点击坐标,很难制定稳定、可执行的安全规则。
但点击往往会进一步触发网络请求。如果最终操作表现为一次 HTTP 调用,那么域名、接口路径、请求方法和参数就提供了更清晰的约束对象。
例如,允许 Agent 在 GitLab 上给 Issue 添加评论,并不等于允许它在同一个 GitLab 站点创建部署密钥。只使用域名白名单,无法区分这两项操作;如果使用已经批准的接口描述,安全系统就能把允许的操作限制到具体 API。
MCP 同样如此。一个工具叫不叫“安全工具”并不重要,更重要的是它来自哪个获批服务、能够执行什么操作、输入参数是否符合当前任务授权,以及工具定义是否在批准后发生变化。COBRA 通过版本绑定与统一约束,尝试防止跨 GUI/MCP 通道的权限绕过。
论文为网站引入了 Agent Sitemap 概念,用机器可读的形式描述可执行操作及其接口字段。这不是普通搜索引擎使用的网页 Sitemap,而更接近网站面向 Agent 发布的能力清单。作者还提出 MESA,尝试通过自动浏览网站生成候选清单,再经过审核批准后使用。
实验结果
为验证这一问题,作者构建了 STEER-Bench,包含 101 项任务、9 组测试场景,共计 199 个攻击测试单元。测试涉及请求字段篡改、目标地址重定向、MCP 越权、跨通道绕过、数据来源混淆、权限过期和多层分支约束等问题。
实验中,普通 ReAct Agent 的攻击成功率为 94.4%,传统 Dual-LLM 架构为 89.5%;完整 COBRA 在 199 个攻击测试单元中实现 0% 攻击成功率。
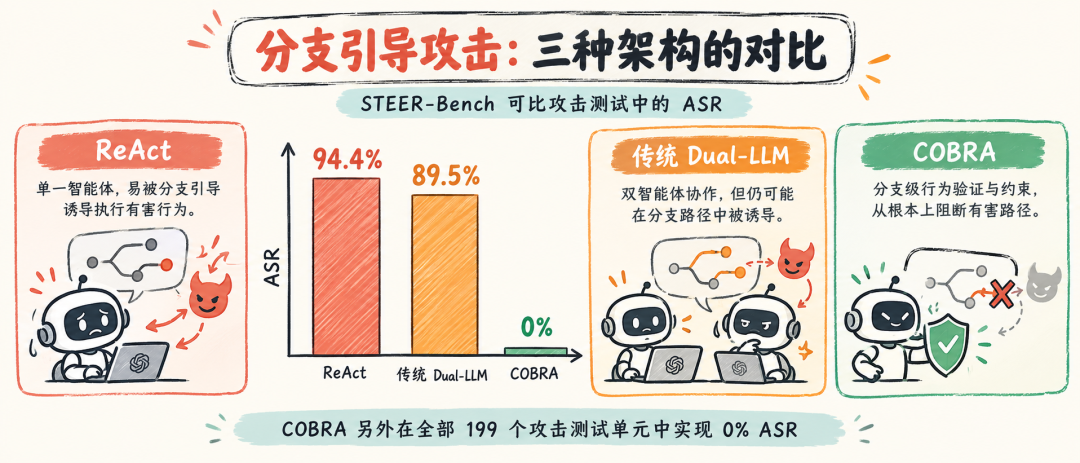
这里需要注意统计口径:94.4% 和 89.5% 来自普通 Agent 与双模型系统均可运行的 74 个可比攻击单元,而 COBRA 的 0% 覆盖全部 199 个攻击单元,三者并非完全相同的测试集合。在正常任务测试中,COBRA 保留了相对于对应 Dual-LLM 基线约 97% 的任务效用,但 138 个正常测试单元中仍出现了 4 次误拦截。
作者还使用 OS-Harm、WASP、MCPTox 和 MCPSecBench 四个已有基准进行验证。四个基准合计 1312 项攻击,其中 1259 项处于 COBRA 声明的防护范围内;在这些覆盖范围内的攻击上,系统同样报告了 0% 成功率。
一个很有代表性的结果来自 WASP:在没有精细网站接口描述时,系统虽然能拦截跨域攻击,却放过了 14 项同一站点内的越权操作;加入经过批准的接口约束后,19 项请求级攻击全部被阻断。它说明 Agent 安全不能只停留在“能访问哪个网站”,还必须区分“在这个网站上能执行什么操作”。
安全边界更清晰了,但并没有解决所有问题
COBRA 的效果很突出,但不应把上述 0% 理解为任何环境下都无法攻破。
首先,参数合规不等于数据真实。如果网页展示的价格是假的,而最终 HTTP 请求只包含商品 ID、不包含实际结算金额,代理就缺少独立核验价格的依据。此时,攻击者仍可能利用视觉误读影响 Agent 的决策。
其次,合法调用不等于语义安全。相同接口可以提交不同文本,其中一段可能包含不适当内容;恶意 MCP 服务甚至可能在接收完全相同的工具名称和参数后,暗中产生不同效果。单靠请求级规则无法识别这些问题。
再次,COBRA 当前重点覆盖 HTTP 和 MCP。直接写入本地文件、使用 SMTP 发送邮件等未纳入相应拦截机制的操作,仍然需要其他安全能力。
最后,严格的预先规划会牺牲灵活性。在 OSWorld-MCP 的 361 项任务中,使用 GPT-5 规划、UI-TARS 执行的 COBRA 完成率为 36.8%,高于仅使用 UI-TARS 的 ReAct 基线 23.5%;但让 Kimi-k2.5 或 Sonnet-5 同时承担规划与执行时,COBRA 的完成率低于各自的 ReAct 基线。原因之一是预先制定的计划难以覆盖所有意外页面状态。
作者尝试通过“融合规划”改善这一点:提前生成五份候选计划,再合并成包含备用路线的固定程序。这能增加对意外情况的适应能力,但也会带来额外计算成本,并不能完全取代运行时的灵活推理。
从提示注入检测走向执行权限控制
这项研究对 Agent 安全产品的启示,并不是要放弃提示注入检测,而是说明仅靠内容识别还不够。
对于普通聊天模型,我们往往重点关心它会不会输出不当内容;而 Agent 能够调用工具、操作网页、修改数据甚至执行交易,风险最终体现在真实动作上。安全系统因此需要同时回答几个问题:当前任务授权了哪些操作?某项操作只有在什么条件下才能发生?参数来自哪里?它是否仍处于有效的权限范围内?
这要求把传统软件安全中的最小权限、执行前授权、参数校验和权限生命周期管理,引入 Agent 的工作流程。内容安全模型可以帮助识别恶意文本和异常意图,确定性执行控制则负责确保高风险动作无法绕过业务边界,两者需要配合,而不是相互替代。
COBRA 仍是具有明确实验边界的研究原型,但它指出了一个重要方向:对 Agent 的安全约束,不应只停留在“它应该怎样思考”,还必须落实到“它最终能够做什么”。
当 Agent 开始真正操作外部系统,安全性的关键也会从是否识别恶意指令,进一步转向是否能够可信地约束每一次实际执行。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
