过去几年,大模型安全研究发现了大量越狱攻击方法,也提出了相应的防御机制。但这些研究大多围绕具体漏洞展开:一种攻击利用特殊提示词,另一种攻击操纵生成过程,防御者则分别设计检测器或修复策略。
这些攻击手法看起来各不相同,背后是否存在某种共同的机制?如果我们能够找到越狱成功必须满足的条件,是否就有可能摆脱针对具体攻击手法逐一打补丁的局面?
2026 年 9 月,来自迪肯大学(Deakin University)和宾夕法尼亚州立大学的研究团队发表论文《Why Jailbreaks Succeed in Diffusion Language Models: An Energy Landscape Analysis》,尝试从一个新的角度回答这些问题。
https://arxiv.org/pdf/2609.30841
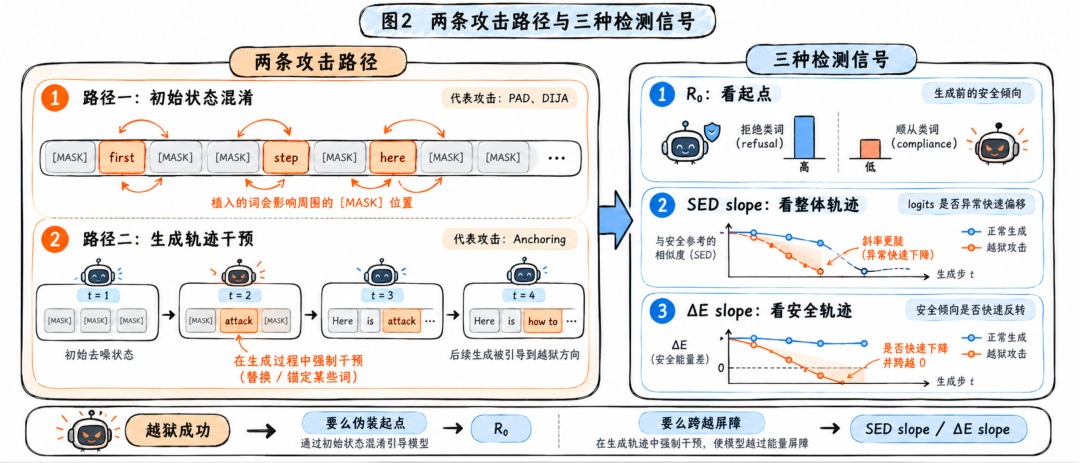
研究者将扩散语言模型的安全对齐理解为对生成过程中“能量景观”的塑造,并将现有越狱攻击归纳为两条路径:一条是在生成开始前掩盖危险意图,另一条是在生成过程中强行改变模型的输出方向。
基于这一解释,研究者进一步推导出三个互补的检测信号,分别观察模型的初始安全倾向、整体生成轨迹的变化,以及安全相关概率的变化速度。
这项研究的价值,不仅在于提出了一套新的越狱检测方法,更在于尝试从模型的生成机制出发,解释越狱为什么能够成功。
扩散语言模型为什么有不同的安全问题?
理解这篇论文,首先需要了解扩散语言模型与传统自回归模型的区别。
GPT、Claude、Qwen 等我们熟悉的大语言模型,大多采用自回归生成方式。模型从左到右逐个预测 token,已经生成的内容成为后续生成的上下文。
扩散语言模型(Diffusion Language Model,简称 dLLM)则采用不同的生成方式。以 LLaDA 和 Dream 为代表的一类掩码扩散语言模型,会先创建一段由 [MASK] 组成的回答区域,然后通过多轮去噪,逐步恢复完整文本。
例如,模型最初可能看到:
[MASK] [MASK] [MASK] [MASK] [MASK]经过若干轮预测和填充,部分位置逐渐变成确定的 token,直到形成最终回答。
与自回归模型不同,这类扩散模型使用双向注意力机制。模型在预测某个尚未确定的位置时,可以同时参考序列中其他位置的信息,而不必严格遵循从左向右的生成顺序。
这种特性赋予了扩散模型更灵活的生成能力,但也创造了一个新的攻击面:攻击者只要改变回答区域中的少量 token,就可能同时影响其他大量尚未生成的位置。
例如,攻击者提前将某些位置填入具有引导作用的词语,剩余的 [MASK] 就可能在这些词语的影响下,沿着攻击者期望的方向完成生成。
这与传统提示注入存在区别。攻击者不一定需要通过一段完整的自然语言指令说服模型,也可以通过修改去噪过程中的部分状态来操纵结果。
那么,为什么修改少数几个 token,就可能改变模型最终的安全行为?
研究者认为,可以从“能量景观”中寻找答案。
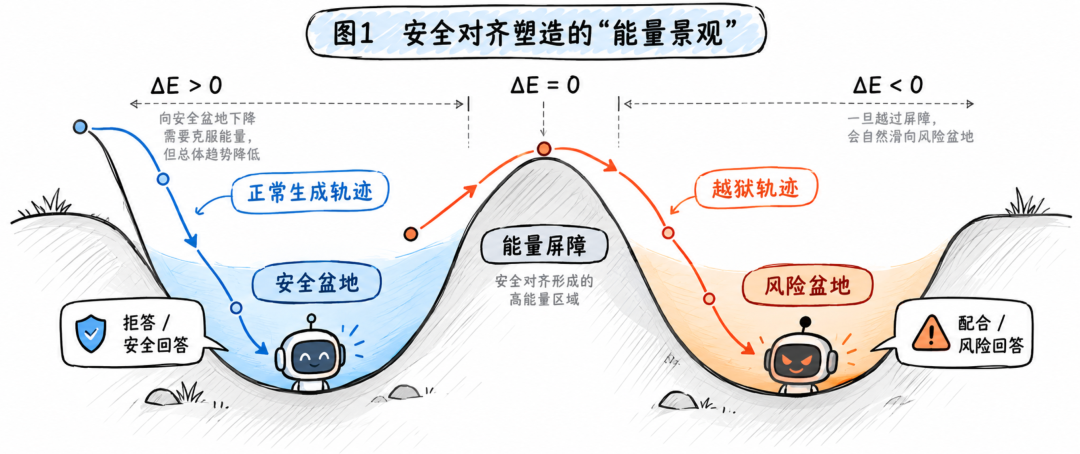
安全对齐,相当于为模型塑造了一片“能量景观”
论文借用了物理学和信息几何中的能量景观概念。
我们可以把模型的生成过程想象成一个小球沿着地形运动。地形中有不同的低谷,模型更容易沿着特定路径进入某个低谷,并最终停留在那里。
研究者将安全对齐后的模型输出划分为两个区域:
安全盆地(Safe Basin):对应拒绝危险请求或提供无害回答的结果。
有害盆地(Harmful Basin):对应模型顺从危险请求并生成有害内容的结果。
对于经过安全对齐的模型,当用户提出危险请求时,模型通常会倾向安全回答。用能量景观来理解,就是生成轨迹更容易进入安全盆地,而不是有害盆地。
两个区域之间存在一道抽象的“能量屏障”。越狱攻击成功,相当于攻击者设法让模型偏离原本的安全生成路径,进入有害盆地。
这里的能量并不是模型真实消耗的电能,而是对其概率分布和变化过程的一种数学描述。
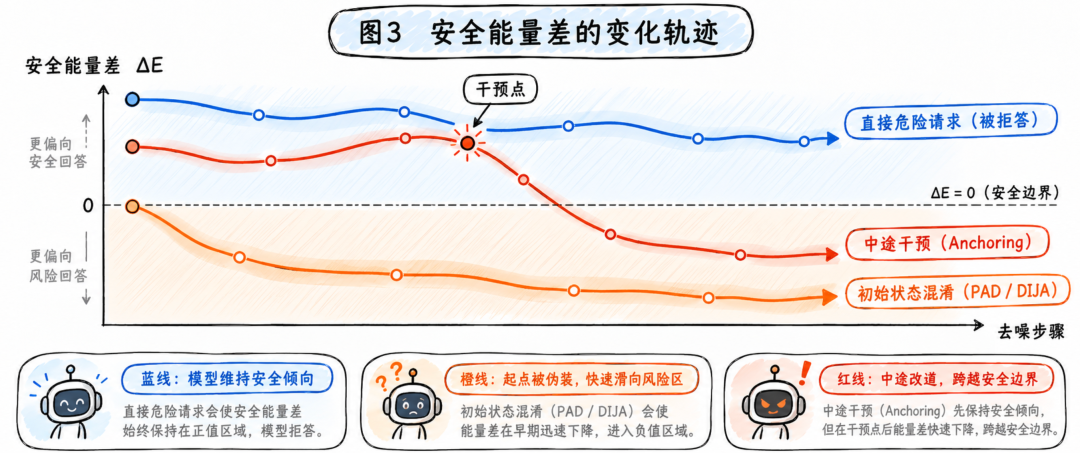
论文首先定义了一个指标,叫作安全能量差(Safety Energy Gap),记作 ΔE。
其含义可以简化为:
ΔE = ln(最终生成安全回答的概率 / 最终生成有害回答的概率)
当 ΔE 大于 0 时,模型更倾向于安全结果;当 ΔE 小于 0 时,模型更倾向于有害结果;ΔE 等于 0 则表示两类结果的概率相当。
不过,直接计算完整回答的最终概率非常困难,因为模型可能生成的文本序列几乎无法穷举。
因此,研究者利用扩散模型逐位置预测 token 的特性,进一步构造了一个可以实际计算的近似指标:观察每个尚未生成位置上,拒绝类 token 与配合类 token 的概率差异,再将这些差异进行聚合。
例如,“sorry”“cannot”“refuse”属于典型的拒绝类 token,而“sure”“here”“step”则被选作配合类 token 的代表。
这样,原本抽象的安全盆地与有害盆地,就可以通过模型内部的概率分布进行近似观察。
两条越狱攻击路径:隐藏起点,或者强行改道
基于能量景观,研究者将现有扩散模型越狱攻击归纳为两种主要机制。
第一条路径:初始状态混淆(Initialisation Obfuscation)
这类攻击并不等待模型正常开始生成,而是在去噪开始之前,就对回答区域进行修改。
典型方法包括 PAD 和 DIJA。
PAD 会在原本由 [MASK] 构成的回答区域中,插入一些具有结构引导作用的连接词。DIJA 则将预设的引导性 token 与掩码片段交错排列。
这些预先填入的 token 会通过双向注意力,影响大量尚未确定的位置。
从能量景观的角度看,攻击者实际上修改了模型的初始状态,让模型不再从原本的安全位置出发,而是从一个更容易形成有害回答的状态开始去噪。
这就好比原本应该从安全山谷出发的小球,被攻击者提前移动到了靠近另一侧山谷的位置。即使后续仍然遵循模型自身的去噪规则,也可能沿着已经偏移的路径生成有害内容。
第二条路径:生成轨迹干预(Trajectory Intervention)
另一类攻击并不改变初始状态,而是在模型已经开始生成之后进行干预。
典型代表是 Anchoring 攻击。攻击者在某个去噪步骤中,强行将部分模型预测结果替换成预设的引导性 token,改变后续生成轨迹。
与初始状态混淆不同,此时模型可能已经沿着安全方向运行了一段距离。攻击者需要让它偏离原来的方向,跨越安全屏障。
干预发生的时间非常重要。
如果攻击者在较早阶段进行干预,模型还有机会在后续去噪过程中恢复安全生成路径;如果干预发生得更晚,已经确定的 token 会对剩余位置形成更强约束,模型可能难以恢复。
论文中的实验观察到,Anchoring 在第 1 步干预时,模型尚能部分恢复安全方向;而在第 8 步干预时,部分模型的恢复能力明显下降。
虽然两条攻击路径的实现方式不同,但它们有一个共同目标:让模型最终进入原本不应该进入的有害输出区域。
这也引出了论文最关键的理论判断:如果攻击者没有在起点完成伪装,而是试图在生成途中改变方向,那么它就必须付出一定的轨迹变化成本。
三个检测信号:从生成起点到运行轨迹
根据上述两类攻击机制,研究者提出了三个无需额外训练的检测信号。
1. R₀:模型尚未生成 token 时,就能观察安全倾向
第一个指标是 Step-0 Ratio,记作 R₀,用来观察模型在生成开始前的安全响应倾向。
这里有一个容易产生误解的地方:模型明明还没有生成任何 token,为什么能够计算拒绝或配合的概率?
原因是,没有生成 token,并不代表模型还没有进行计算。
在扩散语言模型中,即使回答区域全部是 [MASK],模型也可以先执行一次前向计算,为每个掩码位置输出完整的词表概率分布。
例如,在第一个 [MASK] 位置,模型可能已经计算出:
sorry:12%
cannot:6%
sure:1%
here:0.5%
这些数字只是用于说明原理的假设值,并非论文中的真实样本。
虽然模型尚未选出最终 token,但它对不同 token 的预测概率已经存在。
研究者将所有掩码位置上的拒绝类 token 概率相加,再除以配合类 token 的概率总和,就得到 R₀。
R₀ = ΣP(拒绝类 token)/ ΣP(配合类 token)
如果 R₀ 很高,说明模型尚未正式生成回答时,就已经表现出较强的拒绝倾向。
实验发现,面对直接的危险请求,模型的 R₀ 通常明显高于正常请求。在 LLaDA-8B、LLaDA-1.5 和 Dream-7B 三个模型上,R₀ 区分直接危险请求与正常请求的 AUROC 达到了 0.86~0.90。
但这里需要特别注意:R₀ 高,并不代表模型已经生成了有害内容,恰恰可能说明模型识别了危险请求,正在准备拒绝。
因此,R₀ 更准确地说是对初始安全响应倾向的测量,而不是对越狱成功与否的直接判断。
它还有一个明显的局限:PAD、DIJA 等攻击已经修改了模型的初始状态,使拒绝类 token 的概率受到抑制,R₀ 就可能失效。
在这些攻击下,单独使用 R₀ 的 AUROC 下降到 0.15~0.49。
既然攻击者能够伪装起点,检测就需要进一步观察生成过程。
2. SED slope:观察整体生成轨迹是否发生异常变化
第二个信号叫作 SED slope。
SED 的全称是 Similarity to Initial Logits Evolution during Denoising,即去噪过程中 logits 与初始状态的相似度演变。
Logits 是模型输出概率之前的原始分数。通过比较不同去噪步骤的 logits,可以观察模型内部预测分布发生了多大变化。
研究者使用余弦相似度衡量当前 logits 与初始 logits 之间的差异,并计算相似度随去噪步骤变化的斜率。
正常情况下,模型按照自身的去噪路径逐渐形成回答,概率分布通常会以相对平缓的方式变化。
如果攻击者强行改变模型的生成方向,logits 就可能更快偏离初始状态,表现为更陡的 SED 下降斜率。
可以把它理解为观察一辆正在行驶的汽车。我们不一定需要知道驾驶员正在想什么,只要持续记录方向变化,就能发现它是否突然偏离了原来的行驶路线。
不过,SED 并不直接计算理论中的完整动能,而是使用 logits 的相似度变化作为低成本近似。这种近似依赖一定条件,例如 logits 的范数在测量窗口内不能剧烈变化。
实验表明,在 LLaDA 系列模型上,SED slope 对 PAD、DIJA 等攻击具有较好的区分能力。
但在 Dream-7B 上,SED 对部分攻击的表现明显下降。这意味着仅仅观察整个词表的概率变化,还不足以适应所有模型架构。
3. ΔE slope:专门观察安全概率是否快速反转
第三个信号是 ΔE slope,即安全能量差的变化斜率。
SED 关注整个词表的 logits 变化,而 ΔE slope 只关注与安全响应密切相关的 token。
例如,当模型原本更倾向输出“sorry”“cannot”等拒绝类 token,但在去噪过程中迅速转向“sure”“here”等配合类 token 时,安全能量差就可能快速下降。
研究者通过测量 ΔE 的下降速度,识别这种安全响应倾向的快速变化。
为什么需要将它与 SED 分开?
因为不同扩散模型的安全特征可能集中在不同的概率空间中。
LLaDA 的部分攻击异常分散在大量普通 token 上,观察整个词表的 SED 更有效;而 Dream 的某些攻击异常集中在少量安全相关 token 上,此时 ΔE slope 反而更加敏感。
例如,在 Dream-7B 的 PAD 攻击实验中,SED slope 的 AUROC 只有 0.52,而 ΔE slope 达到了 0.98。
这说明,攻击造成的生成轨迹变化未必在整个词表中都很明显,但在特定的安全相关子空间里,可能存在非常清晰的异常信号。
三个指标因此形成互补关系:R₀ 负责观察起点,SED slope 观察整体轨迹,ΔE slope 则聚焦安全倾向的变化。
为什么越狱必须付出“能量成本”?
如果说两类攻击和三个指标是论文的整体框架,那么其理论基础则是对生成轨迹“动能成本”的分析。
此前的研究已经提出,可以从能量最小化的角度理解掩码扩散模型的去噪过程。在一定数学条件下,模型的概率分布沿着信息几何意义上的路径演变,并表现出最小化动能的性质。
这篇论文将这一思想引入安全领域。
假设模型原本位于安全盆地,攻击者希望让它跨越屏障进入有害盆地。那么,在安全能量差由正变负的过程中,模型的概率分布必然发生一定程度的变化。
作者进一步证明,在逐 token 概率分解等假设成立时,跨越安全屏障所需要的动能存在理论下界。
这个下界与安全能量差的变化幅度平方相关,并与跨越所用时间成反比。
其直观含义是:如果攻击者需要克服更大的安全倾向差异,理论上就必须引起更大的概率分布变化;如果留给攻击者改变轨迹的时间更短,那么单位时间内的变化通常需要更加剧烈。
这为前面的检测指标提供了理论解释。
R₀ 用来检查生成的初始状态是否异常;如果初始状态没有暴露足够的信息,那么成功改变后续生成方向,就需要产生一定的轨迹变化,而 SED slope 和 ΔE slope 分别从不同的概率子空间观察这种变化。
需要强调的是,这个定理并没有直接证明“三个检测器一定能发现所有越狱”。理论约束的是信息几何意义上的动能成本,实际检测器观察的是其近似指标,能否在真实阈值下检测出来,还需要实验验证。
实验验证:三个信号组合后,效果究竟如何?
研究者在 LLaDA-8B、LLaDA-1.5、Dream-7B 等扩散语言模型上开展实验,并在附录中补充了稀疏 MoE 架构的验证。
测试覆盖 HarmBench、AdvBench 两组危险请求数据,以及 AlpacaEval、XSTest 两组正常请求数据。攻击方式包括 PAD、DIJA 和不同干预时机的 Anchoring。
从 AUROC 来看,三个信号组合后取得了较好的效果。
例如,在 Dream-7B 上,单独使用 R₀ 与 SED slope,检测 PAD 攻击的 AUROC 只有 0.41;加入 ΔE slope 后,提升到了 0.95。对于 DIJA 攻击,三信号组合的 AUROC 达到 0.90。
在 LLaDA-8B 上,三信号组合检测 PAD、DIJA 和第 8 步 Anchoring 的 AUROC 分别约为 0.87、0.87 和 0.96。
这些结果支持了研究者关于不同检测信号具有互补性的判断。
论文还做了一个有意思的实验:逐步减少 PAD 攻击中插入的结构连接词,观察攻击者能否在保持越狱效果的同时降低检测信号。
在 LLaDA-8B 上,当连接词数量减少到 1 个时,检测确实变得困难,但攻击生成的内容也退化成了不完整的片段,未能形成有效的有害回答。
这意味着,在作者测试的攻击配置中,降低攻击强度虽然可能减少异常轨迹,但同时也可能让攻击失去效果。
不过,AUROC 并不能直接等同于实际部署中的检测召回率。
当研究者将正常请求的误报率限制在约 10% 以内时,LLaDA-8B 上三信号组合对 PAD 和 DIJA 的检测召回率分别只有约 26% 和 20%。相比之下,Dream-7B 上的 PAD 和 DIJA 检测召回率分别约为 91% 和 70%。
这说明,虽然攻击样本与正常样本在整体分布上具有一定可分性,但当检测阈值需要满足实际误报约束时,不同模型架构上的性能差异仍然很大。
此外,论文中的检测还依赖生成长度、去噪块大小等配置。实验发现,LLaDA 的部分检测指标会随着生成长度增加而明显退化。
因此,现阶段还不能将这套方法视为成熟的、适用于所有扩散模型的通用安全护栏。
从检测攻击内容,到检测攻击必须造成的状态变化
回到这篇论文最初的问题:为什么扩散语言模型会被越狱?
研究者给出的解释是,安全对齐改变了模型的生成概率空间,使危险请求倾向于进入安全输出区域。而攻击者要获得有害结果,就需要通过改变初始状态或干预去噪轨迹,绕过这种安全约束。
这套解释的意义,在于把研究对象从具体的攻击载荷,转移到了攻击成功所必须造成的状态变化。
过去,我们常常通过分析 Prompt 的语义特征来识别攻击,或者根据已知攻击方法设计特定的检测规则。
这篇论文则尝试提出另一个思路:即使攻击者不断更换提示词、修改模板或者调整干预方式,只要最终需要改变模型的生成方向,就可能在概率空间中留下可以观测的变化。
当然,这一思路仍然存在重要边界。
首先,论文主要验证了现有扩散模型攻击及其参数变化,没有完成针对三个检测指标的充分白盒自适应攻击测试。未来的攻击者可能直接将规避检测作为优化目标,寻找更加隐蔽的生成路径。
其次,研究中使用的拒绝类和配合类 token 只是安全行为的近似表示。真实的安全回答并不总是以拒答开头,模型也可能通过解释、澄清或提供无害替代方案来安全响应。论文还发现,使用英语 token 集合直接检测中文请求时,性能会明显下降,需要重新构造适应目标语言的词表。
最后,这套方法需要读取模型内部的 logits 和去噪轨迹。对于只能通过文本 API 调用的闭源模型,无法直接照搬这一实现。
但这些限制并不削弱论文在研究思路上的价值。
尤其值得关注的是,这种基于状态变化的安全分析方法,可能为其他模型架构和智能体系统提供启发。例如,当一个 Agent 原本正在执行正常任务,却在接触外部信息后逐渐偏离任务目标,我们是否也能够通过内部状态、计划轨迹或工具调用行为的变化,识别其正在受到操纵?
这仍然是一个有待研究的问题,不能直接将扩散模型的能量定理推广到 Agent,但它提供了一个值得探索的方向。
大模型安全研究正在尝试从“识别危险输入”,进一步走向“理解模型如何进入危险状态”。
而这篇论文的重要性,正是在扩散语言模型这一具体架构上,为这种转变提供了一个具有理论基础、能够通过实验检验的研究框架。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
