传统大模型安全主要关注模型生成的内容是否安全,通过输入审核、输出过滤、安全对齐和提示词注入检测,降低模型产生有害输出的概率。
但 AI Agent 改变了这一局面。
当模型开始调用工具、访问数据库、执行代码和操作外部系统,一次错误决策就不再只是一段错误文本,而可能演变成真实的业务风险:
将企业敏感数据发送到外部邮箱;
执行未经授权的数据库修改;
利用合法凭证访问超出任务范围的资源;
执行恶意代码或危险 Shell 命令;
将过度权限传递给下游 Agent。
传统 Guardrails 的局限在于:它主要控制模型生成什么,却不一定能够控制模型生成的动作是否真正执行。
2026 年发表在《Journal of Reliable and Secure Computing》上的一篇系统性综述《Beyond Guardrails: Runtime Enforcement for Secure AI Agents》,筛选了 58 项相关研究,系统梳理了 Agent 运行时安全的控制位置、技术机制和安全保证方式。
https://www.icck.org/article/abs/jrsc.2026.526903
这篇论文揭示了一个重要趋势:
Agent 安全正在从模型层面的安全护栏,向独立的运行时执行控制体系演进。
本文从企业安全架构出发,梳理这一体系的核心组成与落地方法。
从 Model Guardrails 到 Runtime Enforcement
两者最本质的区别在于控制对象。
对比维度 | Model Guardrails | Runtime Enforcement |
|---|---|---|
控制对象 | 模型输入与输出 | Agent 执行动作 |
核心问题 | 生成内容是否安全 | 动作是否获得授权 |
主要技术 | 内容审核、对齐、注入检测 | 权限控制、动作校验、执行隔离 |
作用位置 | 模型输入输出链路 | 工具调用与执行链路 |
防御目标 | 降低模型犯错概率 | 限制错误决策产生实际影响 |
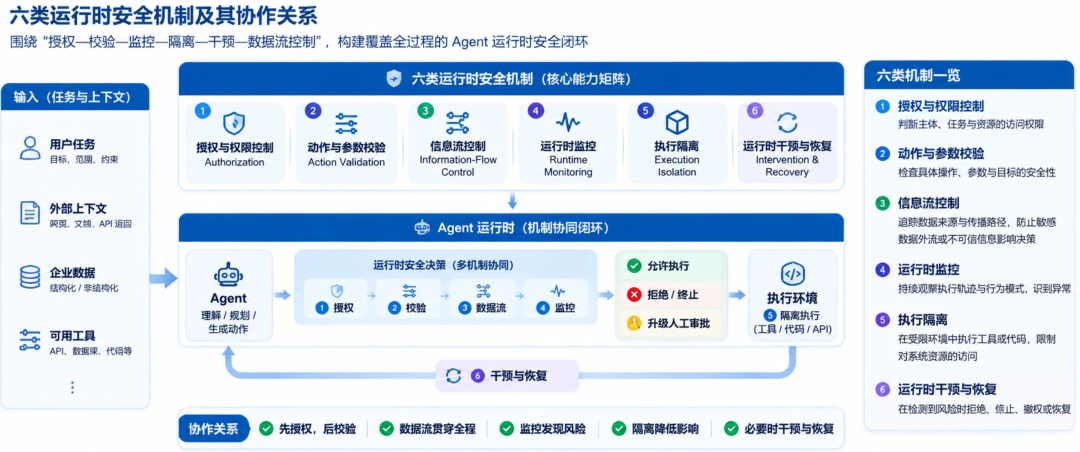
Runtime Enforcement 的核心思想是将动作生成与动作执行分离:
Agent 负责理解任务、规划和提出动作。
独立安全系统负责检查权限、参数和执行上下文。
只有通过安全检查的动作才能进入执行环境。
例如,Agent 生成了一个向外部邮箱发送客户数据的 Tool Call,即使模型自身没有识别出风险,运行时安全系统仍然可以根据任务授权和数据安全策略拒绝执行。
模型负责提出动作,安全系统负责授权,受控环境负责执行。
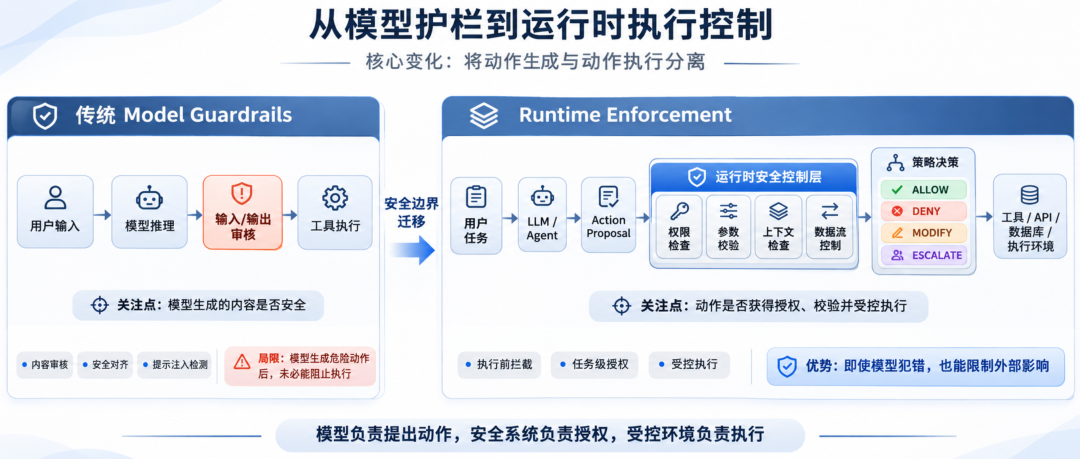
Agent 运行时安全的三层控制边界
论文对 58 项研究进行了分类,发现运行时安全控制主要分布在三个位置:
控制位置 | 研究数量 | 占比 | 核心职责 |
|---|---|---|---|
Tool / Action Boundary | 33 | 56.9% | 工具调用拦截 |
Agent Runtime / Harness | 18 | 31.0% | 执行状态与行为控制 |
OS / Process / Execution | 7 | 12.1% | 系统级执行隔离 |
2.1 Tool / Action Boundary:工具调用边界
位于模型生成 Tool Call 之后、工具实际执行之前。主要检查:
Agent 是否具有调用权限;
当前任务是否允许执行该操作;
参数、目标资源是否符合安全策略;
是否需要人工审批。
这是最直接的执行控制点,也是企业最应该优先建设的一层。
2.2 Agent Runtime / Harness:运行时控制
关注整个 Agent 的执行过程,而不仅仅是单次工具调用。主要管理:
当前任务与授权范围;
Agent 执行历史;
数据来源与传播路径;
多步骤行为异常;
权限动态变化;
多 Agent 委托关系。
这一层解决的是单个动作看似合法,但多个动作组合起来产生风险的问题。
2.3 OS / Process / Execution:系统级隔离
通过操作系统和执行环境限制 Agent 的实际能力。典型技术包括:
Linux Namespace、Seccomp;
容器与进程隔离;
文件系统权限;
网络访问控制;
CPU、内存及执行时间限制。
即使上层安全判断失效,也能限制 Agent 对宿主机和外部资源的影响范围。
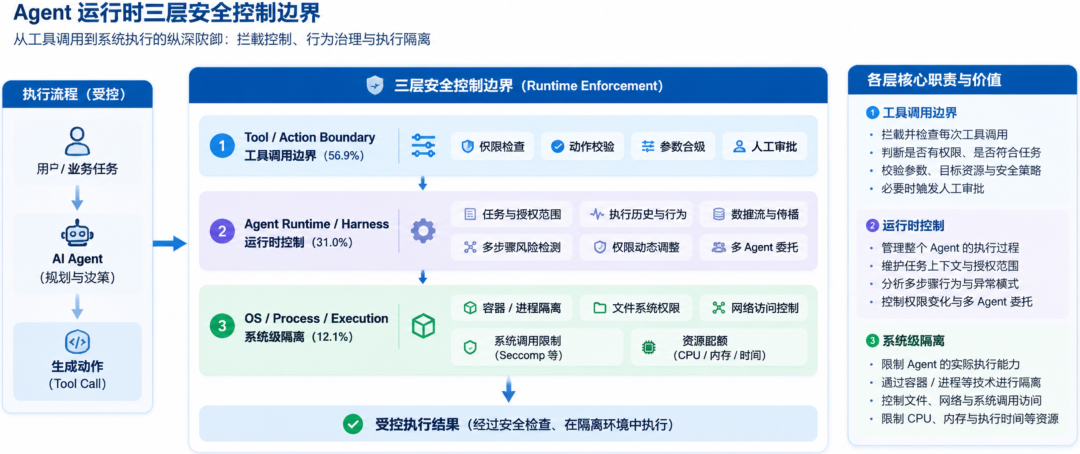
六类核心运行时安全机制
论文将相关研究归纳为六类安全机制:
安全机制 | 研究数量 | 占比 | 核心作用 |
|---|---|---|---|
Authorization | 41 | 70.7% | 授权与权限控制 |
Action Validation | 34 | 58.6% | 动作与参数校验 |
Intervention & Recovery | 20 | 34.5% | 运行时干预与恢复 |
Information-Flow Control | 18 | 31.0% | 信息流控制 |
Runtime Monitoring | 17 | 29.3% | 执行行为监控 |
Execution Isolation | 9 | 15.5% | 执行环境隔离 |
注:采用多标签统计,同一研究可能涉及多种机制。
其中有三个技术方向尤其值得关注。
3.1 Authorization:从工具权限到任务级授权
传统 IAM 关注主体、资源和操作权限,但 Agent 还需要考虑当前任务。例如,Agent 拥有数据库查询权限,不代表它可以访问所有客户数据。因此,需要引入 Task-scoped Authorization,将权限与具体任务、资源、操作范围和有效期绑定,并支持动态撤销。
3.2 Action Validation:从工具白名单到动作校验
授权解决的是能不能做,动作校验解决的是这次具体操作是否安全。例如,Agent 获得了邮件工具的调用权限,仍然需要检查收件人、附件、数据敏感级别和当前任务是否允许外发。企业需要将安全检查深入到 Tool、Action、Resource 和 Parameters,而不能只做工具级白名单。
3.3 Information-Flow Control:控制数据如何流动
传统权限系统关注能否访问数据,IFC 则进一步关注数据能否流向某个目标。例如:
客户数据库↓数据标签:CONFIDENTIAL↓Agent Memory↓报告生成↓外部邮件↓IFC 检查↓拒绝敏感数据外流
核心技术包括 Data Provenance、Security Label 和 Taint Tracking。它既可以保护企业敏感数据,也可以追踪外部不可信内容对后续 Agent 行为的影响,是防御间接提示注入的重要技术方向。
其他三类机制则分别负责持续监控执行轨迹、限制实际执行能力,以及在出现异常时拒绝、终止、撤权或恢复。
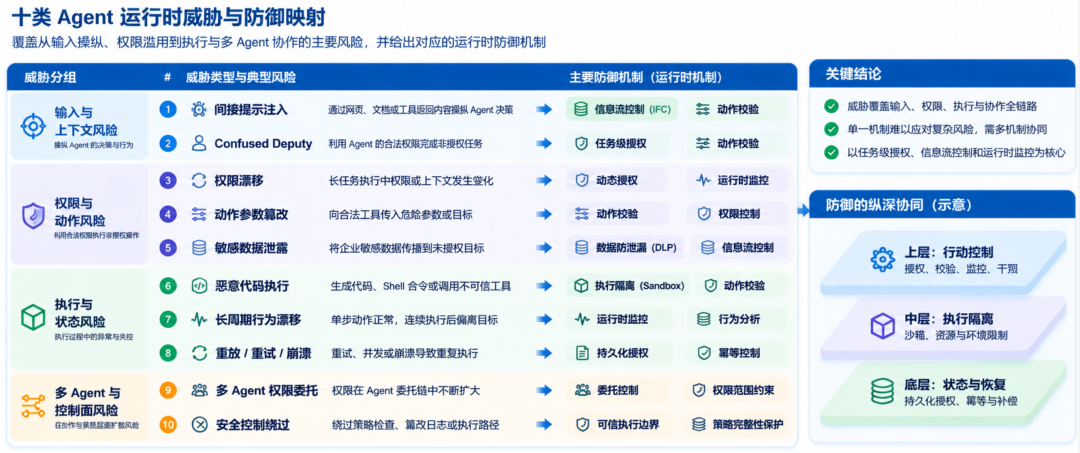
企业 Agent 需要防御的十类运行时威胁
论文进一步归纳了十类主要威胁与失效模式:
威胁类型 | 典型风险 | 主要防御机制 |
|---|---|---|
间接提示注入 | 外部文档操纵 Agent 决策 | IFC、动作校验 |
Confused Deputy | 利用 Agent 合法权限执行非授权任务 | 任务级授权 |
权限漂移 | 长任务执行中权限失效或变化 | 动态授权 |
动作参数篡改 | 合法工具执行危险参数 | Action Validation |
敏感数据泄露 | 数据流向未授权目标 | DLP、IFC |
恶意代码执行 | 代码或第三方工具危害系统 | Sandbox |
长周期行为漂移 | 多个正常动作组合成异常行为 | Runtime Monitoring |
Replay / Retry / Crash | 重试、并发和崩溃导致重复执行 | 持久化授权、幂等控制 |
多 Agent 权限委托 | 权限在委托链中不断扩大 | Delegation Control |
安全控制绕过 | 执行路径绕过策略检查 | 可信执行边界 |
其中三个问题尤其值得企业关注:
Confused Deputy:合法权限被用于非法目的。
Agent 拥有数据库和邮件工具的合法权限,但攻击者通过间接提示注入操纵 Agent,将内部数据发送给外部邮箱。攻击者没有直接突破权限系统,而是利用了一个拥有合法权限的代理。
Semantic Replay:同一授权意图被重复执行。
例如付款请求超时后,Agent 重新申请 Token 并再次付款。即使每个 Token 都是一次性的,也可能产生重复交易。因此需要持久化授权状态和事务级幂等控制。
Multi-Agent Delegation:权限在 Agent 网络中扩散。
主 Agent 将任务委托给子 Agent,如果权限被简单复制,下游 Agent 可能获得超出原始任务范围的能力。必须建立权限继承、范围约束和动态撤销机制。
PMA:如何评价运行时安全机制的可靠性?
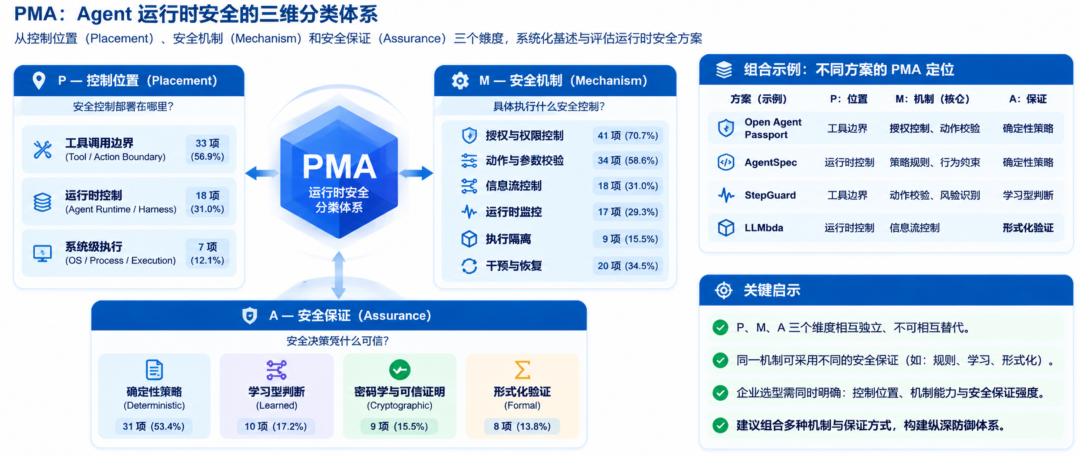
论文提出了一个值得借鉴的三维分类体系:PMA。
维度 | 核心问题 | 分类 |
|---|---|---|
Placement | 安全控制部署在哪里? | Tool / Runtime / OS |
Mechanism | 具体做什么? | 六类运行时机制 |
Assurance | 安全决策凭什么可信? | 四种安全保证 |
其中,Assurance 将研究分为四类:
安全保证 | 研究数量 | 占比 | 典型技术 |
|---|---|---|---|
Deterministic | 31 | 53.4% | 规则引擎、确定性策略 |
Learned | 10 | 17.2% | 风险分类器、学习型护栏 |
Cryptographic | 9 | 15.5% | 数字签名、可信记录 |
Formal | 8 | 13.8% | 形式化验证、模型检验 |
这三个维度相互独立。
例如,一个 Tool Call 拦截系统可以使用确定性规则,也可以使用学习型模型,或者结合形式化约束。
它们部署位置相同,但提供的安全保证不同。
因此,企业不能仅仅判断一个产品是否具备 Agent Guardrails,还需要评估:
安全控制是否位于真正的执行边界?
是否具备确定性的权限约束?
学习型判断是否存在误判和绕过风险?
关键安全属性是否能够形式化验证?
安全决策和执行记录是否具有完整性?
企业级 Agent Runtime Security 参考架构
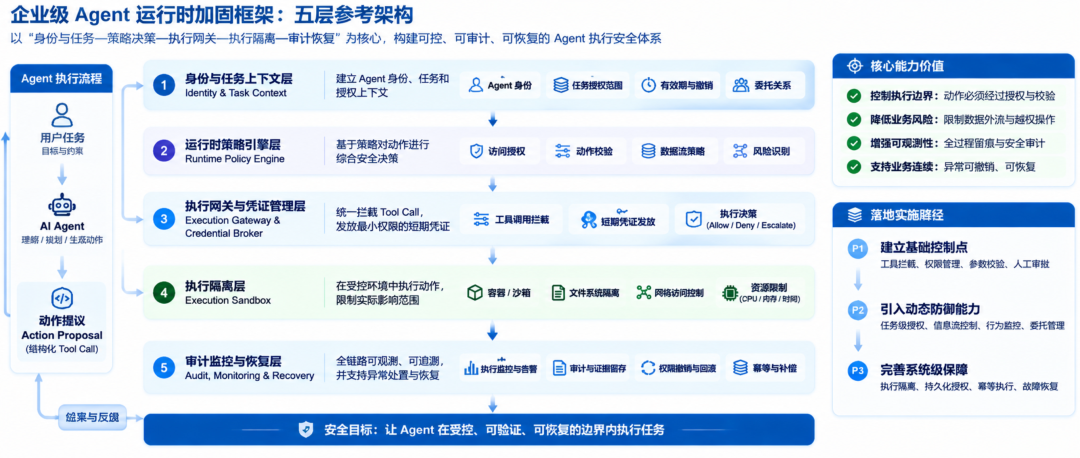
结合上述技术,可以将企业运行时安全体系抽象为五个核心模块。
6.1 五层参考架构
第一层:Agent Identity & Task Context。建立 Agent 身份、任务身份和授权上下文,明确谁发起任务、允许访问哪些资源、允许执行哪些操作,以及授权何时失效。
第二层:Runtime Policy Engine。统一执行身份授权、动作校验、数据流策略和风险干预决策,输出 ALLOW、DENY、MODIFY 或 ESCALATE。
第三层:Execution Gateway & Credential Broker。拦截所有 Tool Call,根据策略决策获取限定范围的短期凭证,避免 Agent 直接持有高权限长期凭证。
第四层:Execution Sandbox。通过容器、进程、文件系统和网络隔离,限制工具与代码的实际执行能力。
第五层:Audit, Monitoring & Recovery。记录完整执行轨迹,支持异常告警、权限撤销、执行终止、事务恢复和审计追溯。
6.2 企业落地的三个阶段
阶段 | 建设重点 | 核心目标 |
|---|---|---|
P1 基础控制 | Tool Call 拦截、IAM、参数校验、人工审批 | 建立独立执行控制点 |
P2 动态防御 | 任务级授权、IFC、行为监控、多 Agent 委托 | 实现上下文感知的安全控制 |
P3 深度加固 | Sandbox、持久化授权、幂等执行、故障恢复 | 控制复杂攻击与执行故障的影响 |
评估体系也不能只关注攻击拦截率,还应同时关注:
Security: 攻击成功率、未授权执行率、数据泄露率;
Utility: 正常任务成功率、误拦截率、人工审批率;
Cost: 授权延迟、资源开销和系统吞吐量。
只有同时满足安全、效用和成本要求,运行时加固才能真正进入生产环境。
未来仍需解决的四个问题
论文最后指出,当前研究仍存在四个重要的开放方向:
Durable Authorization: 如何保证授权在多轮执行、重试、并发和系统崩溃后仍然有效且不被重复消费?
Secure Delegation: 如何保证多 Agent 委托过程中权限不扩散,并且能够全链路撤销?
Composable Enforcement: 如何保证 IAM、DLP、IFC、Sandbox 等不同安全机制之间的策略一致性?
Recovery: 当 Agent 已经产生不可逆的外部副作用时,如何通过幂等、事务和补偿机制控制损失?
这四个方向说明,Agent 运行时安全已经不只是模型安全问题,还涉及传统计算机安全、分布式系统、操作系统和事务管理。
让模型犯错,但不让错误突破安全边界
Runtime Enforcement 带来的核心变化,是重新划分 Agent 系统中的决策权与执行权。
模型负责理解任务、规划和提出动作;独立安全系统负责授权与校验;受控执行环境负责限制实际影响。
从技术演进来看,Agent 安全正在经历三个转变:
从 Model-Centric Security 走向 Action-Centric Security;
从静态权限管理走向任务级动态授权;
从单点拦截走向全生命周期执行控制。
这并不意味着传统模型安全已经不重要。模型对齐、提示注入检测和内容审核依然是纵深防御的重要组成部分。
但企业不能再将模型本身视为 Agent 系统最后一道安全防线。
真正成熟的 Agent 安全架构,应该允许模型犯错,但不能让模型仅凭自己的错误决策,就突破企业的权限和执行边界。
模型负责思考,安全系统负责授权,受控环境负责执行。
这才是企业级 Agent 从可用走向可信的关键一步。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
