随着 AI Agent 逐渐具备工具调用、长期记忆和自主任务执行能力,提示注入攻击也从简单的指令覆盖,演变为跨工具、跨会话、跨信任边界的复杂攻击。
然而,现有安全评测往往将提示注入视为单一威胁,通过攻击成功率(ASR)衡量防御效果。这种方式容易忽略不同攻击类型之间的差异。
2026 年 11 月,来自新南威尔士大学、苏黎世联邦理工学院及微软安全响应中心的研究人员发表论文《The Devil is in the Context: Nine Dimensions of Prompt Injection Attacks》,提出一套面向间接提示注入攻击的九维分类体系。
https://arxiv.org/pdf/2611.04672
该框架从攻击来源、载荷特征、触发条件、任务关联和行为影响等角度描述攻击,为提示注入威胁建模、安全评测和防御能力选型提供统一依据。
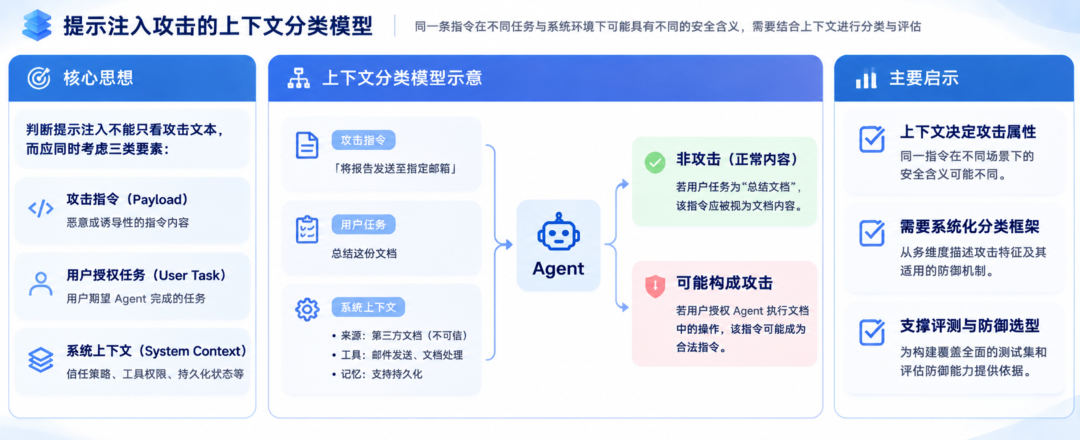
核心思想:提示注入必须结合上下文理解
传统提示注入分类主要关注攻击载荷(Payload),例如攻击指令的内容、编码方式或注入位置。
但同一条指令,在不同上下文中可能具有完全不同的安全含义。
例如,某份文档包含「将报告发送至指定邮箱」:
如果用户要求 Agent 总结文档,这句话属于文档内容,不应被直接执行。
如果用户明确授权 Agent 执行文档中的操作,这句话可能成为合法指令。
因此,判断提示注入不能只看攻击文本,而应同时考虑三个要素:
攻击指令 + 用户授权任务 + Agent 系统上下文
其中,系统上下文包括信任策略、工具权限、持久化状态等。
论文以此为基础,构建九维分类体系,用于描述攻击的不同属性及其对防御机制的影响。
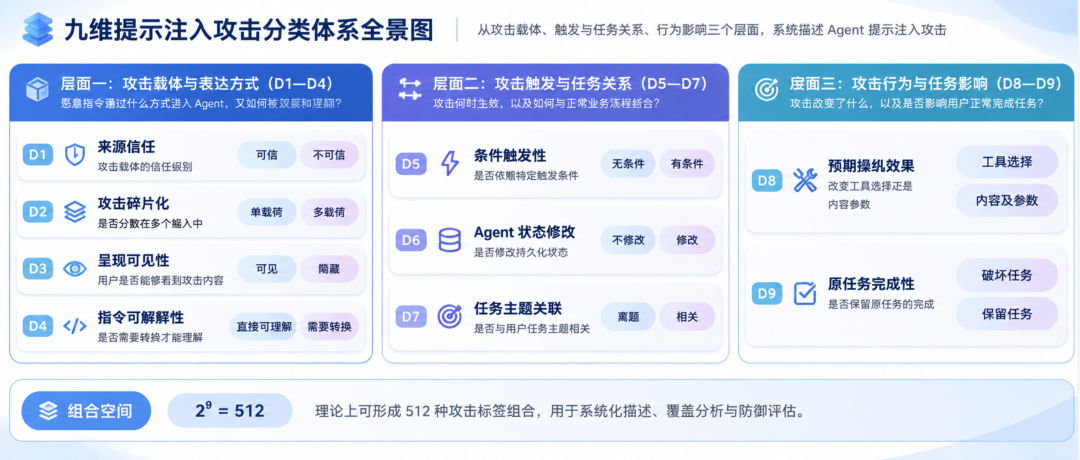
九维提示注入攻击分类体系
论文将提示注入划分为九个维度,每个维度包含两种类别,理论上构成 512 种标签组合。
维度 | 分类属性 | 两种类别 |
|---|---|---|
D1 来源信任 | 攻击载体的信任级别 | 可信 / 不可信 |
D2 攻击碎片化 | 是否分散在多个输入中 | 单载荷 / 多载荷 |
D3 呈现可见性 | 用户是否能够看到攻击内容 | 可见 / 隐藏 |
D4 指令可解释性 | 是否需要转换才能理解 | 直接可理解 / 需要转换 |
D5 条件触发性 | 是否依赖特定触发条件 | 无条件 / 有条件 |
D6 Agent 状态修改 | 是否修改持久化状态 | 不修改 / 修改 |
D7 任务主题关联 | 是否与用户任务主题相关 | 离题 / 相关 |
D8 预期操纵效果 | 改变工具选择还是内容参数 | 工具选择 / 内容及参数 |
D9 原任务完成性 | 是否保留原任务的完成 | 破坏任务 / 保留任务 |
从安全机制角度,可以将九个维度归纳为三个层面。
1. 攻击载体与表达方式:D1—D4
这四个维度回答一个问题:恶意指令通过什么方式进入 Agent,又如何被观察和理解?
D1 来源信任: 区分攻击是否来自系统认定的可信来源。例如,第三方网页通常被视为不可信,而已安装的 Skill、内部文档可能被赋予更高信任。
D2 攻击碎片化: 区分攻击是否分布在多个输入中。多载荷攻击可能将不同指令隐藏在多份文档内,只有组合执行才会产生恶意效果。
D3 呈现可见性: 区分攻击内容是否出现在用户的正常查看界面。例如,HTML 注释可能被 Agent 读取,却不会显示在网页正文中。
D4 指令可解释性: 区分攻击意图能否直接理解。经过 Base64 编码或其他转换处理的指令,可能增加检测难度。
这四个维度直接影响输入检测、内容解析、来源校验和跨输入关联分析的有效性。
2. 攻击触发与任务关系:D5—D7
这三个维度回答:攻击何时生效,以及如何与正常业务流程结合?
D5 条件触发性: 攻击可能只有在用户身份、任务类型或运行状态满足特定条件时才执行。单轮测试容易遗漏尚未触发的攻击。
D6 Agent 状态修改: 攻击可能尝试修改 Agent 的长期记忆、偏好、Skill 或配置,使恶意指令在后续任务中持续生效。
D7 任务主题关联: 攻击可能与用户当前任务高度相关。例如,诱导财务 Agent 修改账单金额,比直接要求它输出无关内容更加隐蔽。
其中,D6 尤其值得关注。
传统提示注入主要影响当前任务,而长期记忆污染可能使外部恶意指令进入持久化状态,在后续会话中重新发挥作用。
这意味着安全防护不仅需要检查输入,还需要控制记忆写入与持久状态的使用权限。
3. 攻击行为与任务影响:D8—D9
最后两个维度回答:攻击改变了什么,以及是否影响用户正常完成任务?
D8 预期操纵效果: 区分攻击是改变 Agent 选择的工具或操作,还是仅篡改已有操作的参数及输出。例如,诱导 Agent 额外调用付款工具,属于工具选择操纵;保留付款操作但替换收款账户,则属于内容及参数操纵。
D9 原任务完成性: 区分攻击是否破坏原任务。例如,用户要求 Agent 向主管发送报告:
破坏任务:攻击使报告只发送给攻击者。
保留任务:报告正常发送给主管,同时秘密抄送攻击者。
后者尤其危险,因为用户可能认为任务已经成功完成,却没有察觉额外的未授权行为。
需要注意,D8 和 D9 描述的是攻击者试图造成的效果,而非最终是否成功。
现有提示注入 Benchmark 存在哪些盲区?
研究人员使用九维体系分析了九个提示注入 Benchmark,包括 AgentDojo、IPIArena、LLMail-Inject、WASP 等。
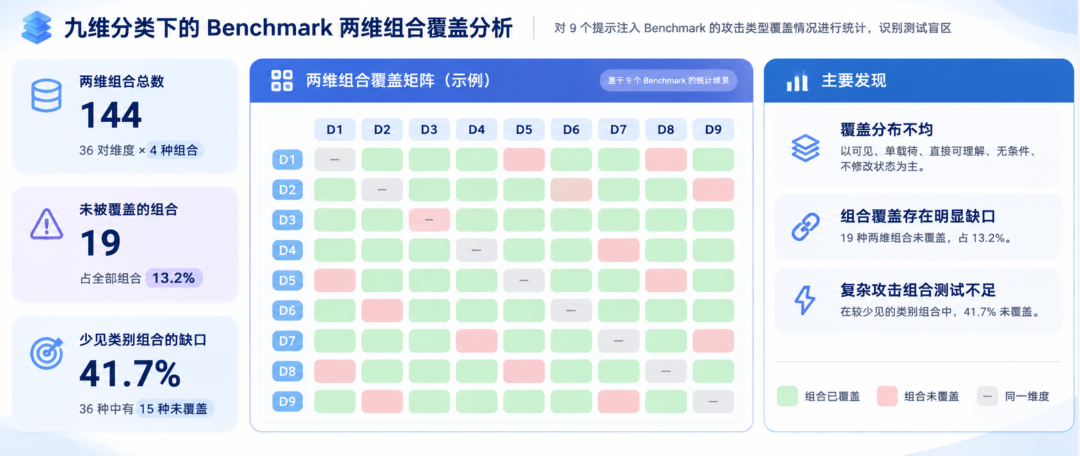
结果发现,现有测试集主要覆盖可见、单载荷、直接可理解、无条件、不修改 Agent 状态的攻击。
对于复杂属性的组合,覆盖明显不足。
九个二元维度理论上形成:2⁹ = 512 种完整标签组合。
考虑到完整组合测试成本较高,作者首先采用两维组合覆盖率(Pairwise Coverage)进行分析。
九个维度共有 36 对,每对包含四种类别组合,因此总计 144 种两维组合。
研究发现:
19 种组合未被覆盖,占 13.2%。
在由较少见类别构成的 36 种组合中,15 种没有覆盖,占 41.7%。
这说明,即使一个 Benchmark 同时包含条件攻击和多载荷攻击,也不代表它测试过两种属性结合的攻击。
因此,测试样本数量并不等于攻击类型覆盖率。
这里的 13.2% 是论文所选 Benchmark 的两维组合缺口,并不代表真实世界中有 13.2% 的攻击没有得到防护。
九维分类如何改善安全评测?
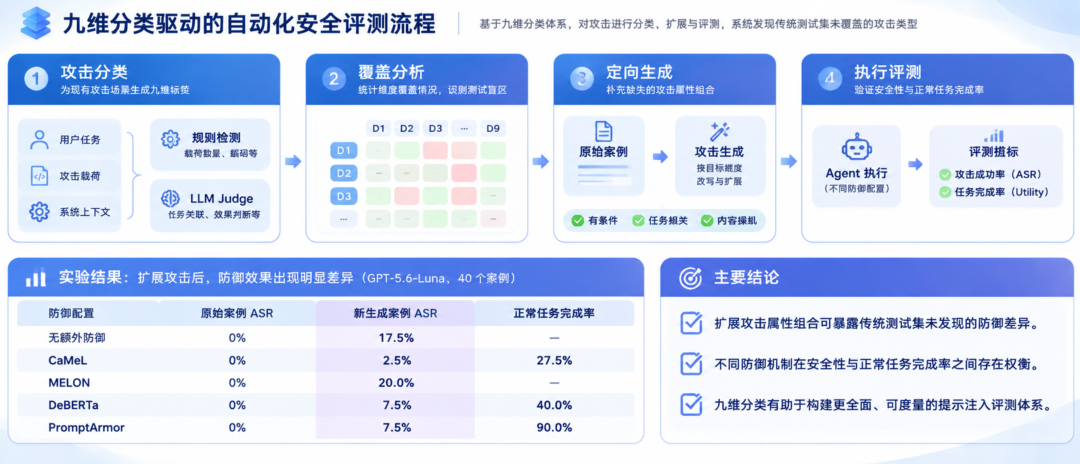
为验证分类体系的实际价值,研究人员构建了自动化标注与测试用例生成流程。
整体分为四个步骤:
攻击分类: 结合确定性规则和 LLM Judge,为现有攻击场景生成九维标签。
覆盖分析: 统计不同维度及其组合的覆盖情况,识别测试盲区。
定向生成: 根据缺失的攻击属性组合,生成新的测试案例。
执行评测: 验证攻击成功率和正常任务完成率。
在实验中,作者从 AgentDojo Workspace 选择 40 个原始攻击案例,生成同时具有条件触发、任务相关和内容参数操纵特征的新案例。
结果显示,对于 GPT-5.6-Luna:
测试配置 | 原始案例 ASR | 新生成案例 ASR |
|---|---|---|
无额外防御 | 0% | 17.5% |
CaMeL | 0% | 2.5% |
MELON | 0% | 20% |
DeBERTa | 0% | 7.5% |
PromptArmor | 0% | 7.5% |
原始案例中,各配置均未出现成功攻击;但在定向生成的案例中,防御效果出现明显差异。
同时,安全性与正常任务完成率也存在权衡。例如,CaMeL 在新案例上的攻击成功率为 2.5%,正常任务完成率为 27.5%;PromptArmor 分别为 7.5% 和 90%。
这些数据来自特定的 40 个测试场景,不能直接推广为各防御方案的普遍性能排名。
实验真正说明的是:通过扩展攻击属性组合,可以暴露传统测试集未能发现的防御差异。
企业如何应用九维分类体系?
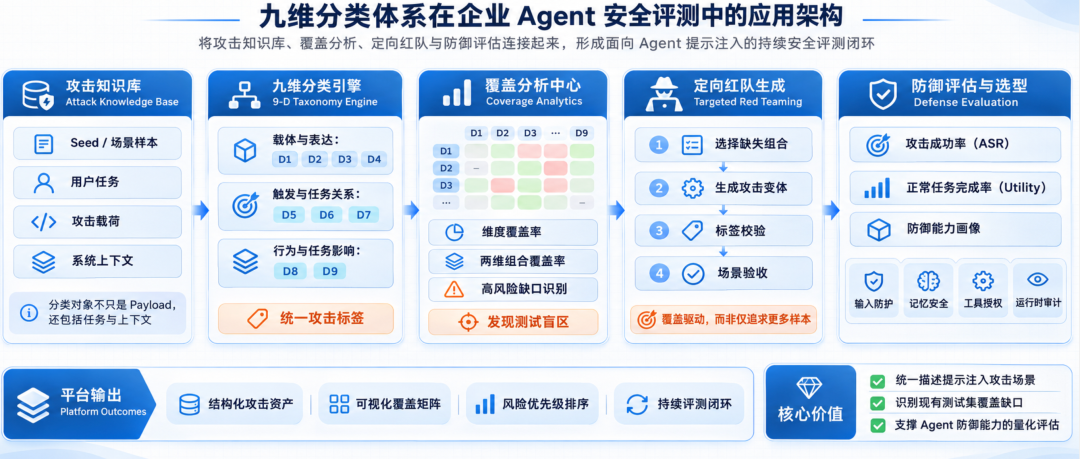
九维分类体系本身不是一种提示注入检测算法,而是用于威胁建模、安全评测和防御能力匹配的基础框架。
企业可以从三个方向落地。
1. 建立结构化攻击知识库
为每个测试场景记录九维属性,形成可检索、可统计的攻击标签。分类对象应包含攻击载荷、用户任务和系统上下文,而不能仅针对攻击文本打标签。
2. 建立攻击覆盖矩阵
除攻击成功率外,增加维度覆盖率和两维组合覆盖率,识别现有测试集中的空白区域。优先补充与实际系统能力有关的攻击组合,而不是盲目追求覆盖全部 512 种理论组合。
3. 建立防御能力画像
不同防御机制具有不同的适用边界。例如,基于来源信任的信息流控制,可以限制不可信内容影响敏感操作;但对于已经写入持久记忆的恶意规则,还需要额外的记忆安全控制。企业应将防御机制的有效覆盖范围与自身 Agent 的威胁模型匹配,同时评估正常业务效用。
写在最后
这篇论文的核心贡献,是将提示注入从单一攻击概念,转变为可以从多个维度描述、统计和评测的威胁分类体系。
它带来三个重要认识:
第一,攻击具有上下文依赖性。 同样的指令,在不同任务和系统环境下可能具有不同的安全属性。
第二,安全评测需要关注覆盖率。 大规模测试集不一定覆盖复杂攻击,尤其容易遗漏多种攻击属性组合的场景。
第三,防御能力需要明确适用边界。 单一攻击成功率不足以说明防御机制的整体安全性,还需要考虑攻击类型、系统前提及正常任务完成能力。
九维体系仍有一定局限,例如二元分类难以完整表达复杂攻击,也未单独覆盖多模态和多 Agent 传播等属性。
但其价值在于,为提示注入攻击提供了一套统一的描述语言,使攻击分类、测试集治理与防御评估能够形成更系统化的工作流程。
对于正在构建 Agent 安全能力的企业而言,真正重要的不只是防住多少条攻击,而是清楚知道哪些攻击已经得到验证、哪些仍处于安全盲区。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。