注:图片由会议主办方提供
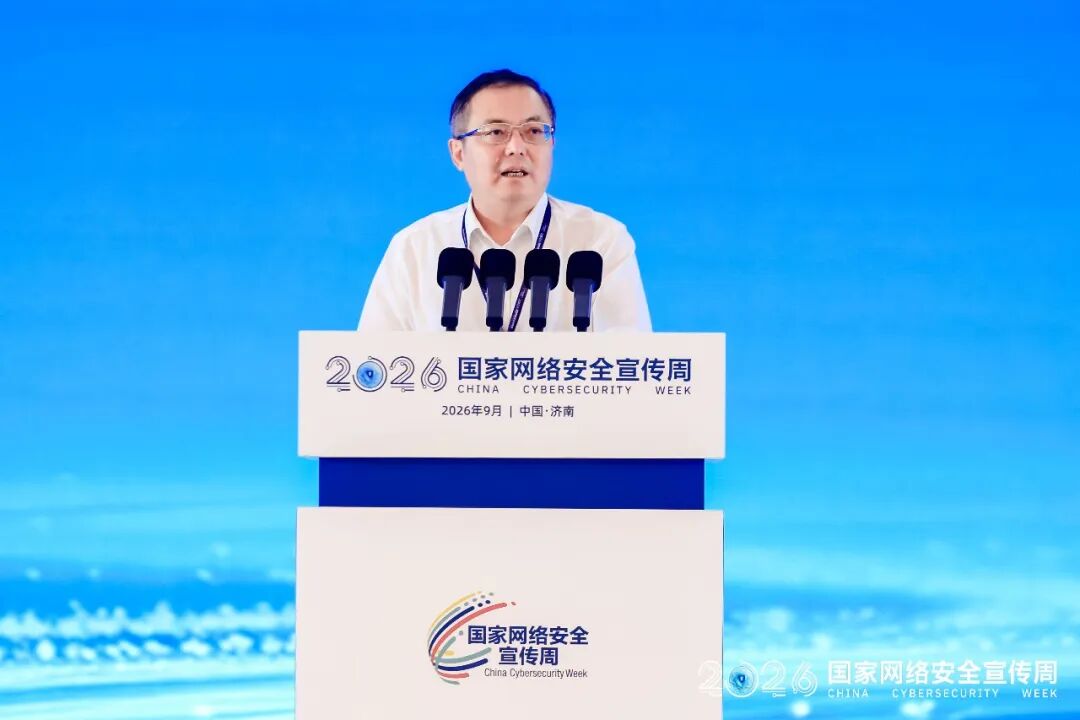
9月14日 ,2026年国家网络安全宣传周“网络安全技术高峰论坛”在山东国际会展中心举行。中国工程院院士云晓春在会上作了《AI的供应链安全形势及挑战》的主题演讲。以下为演讲主要内容。
尊敬的各位领导,各位专家,大家上午好。今天主要想跟大家探讨一下AI的供应链安全问题。
一、AI供应链安全的对象,是持续变化的系统行为
AI供应链安全的对象是持续变化的系统行为。它不但要保证组件可信,还要保证过程可信,行为可信。传统的清单式供应链治理主要回答了“装了什么”,AI供应链治理还必须回答“为何这样行动?何时发生变化?后果是否可控?”
二、AI供应链覆盖七类相互依赖的资产
包括数据、模型、软件、算力、平台、工具、服务,任何一类资产的来源、更新或权限变化,都可能改变最终模型的安全、合规和业务表现。
三、相比于传统的软件供应链,AI供应链多出三类动态风险
第一是数据风险,数据的输入是可塑造整个AI行为的,数据的来源、分布、标注、污染等不仅影响了模型质量,还可能嵌入偏差、后门与合规风险。第二是模型风险,模型的组件具有涌现行为,权重、适配器、检索内容这些组合可能会产生不可预期的涌现行为,所以我们单独运用单一的版本号来描述供应链是不够的。第三是AI的供应链在运行期仍会发生变化,通过策略与供应商更新可在不重新构建应用的情况下改变结果。因此,AI的构建不是一次构建,一次验收,是持续的配置和行为的管理。
四、高度复用与服务化让依赖关系更深、更隐蔽
AI的供应链有个非常鲜明的特点,是高度复用和服务化的。具体体现在:一是基础模型复用,大多数AI应用不会零开始训练,往往都是依赖于第三方的基础模型、适配器等。二是开源生态越来越加速,模型仓库、数据集和代码包提升创新速度,也带来仿冒来源、恶意文件和维护中断风险。三是AI云化、API服务化趋势越来越明显,模型、向量数据库、审核、搜索与监控以API交付,用户难以看到全部底层组件与变更。四是智能体可组合,工具、插件、MCP服务与多智能体形成运行期依赖,第三方组件可以影响动作与权限。五是算力与地缘的约束,芯片、云区域、网络、能源和出口限制影响容量、可替代性、连续性与数据边界。AI的供应链风险从“软件是否有漏洞”扩展为“关键能力是否透明、可替代,可验证”。
五、供应链攻击通过信任继承进入高价值环境
跟传统的供应链一样,AI供应链的攻击也是通过信任继承的方法进入到高价值环境中,当然它的上游入口,制品改变,合作分发,下游执行,业务后果都有其独特的特点。上游复用率高、制品难检查、下游权限高、更新自动化、事件跨组织、责任边界模糊等因素放大了攻击的风险。因此,对于供应链的攻击防御重点应前移到来源、构建、签名与验收,同时保留运行期发现和撤销能力。
六、部署边界应限制未知制品的执行能力与数据可达性
在安全部署上,因为前面的这种风险和攻击特点,部署的边界应该限制未知制品的执行能力和数据的可达性。典型的是要采用隔离加载的方法,对于未知或新版本制品先在无敏感数据,无外网,无长期凭证的环境中解析与试运行。模型服务、智能体工具使用独立工作负载身份与短期凭证,不能上来就完全信任它,部署前要验证签名、来源、评测、场景、数据级别、地域和批准有效期,保留已知安全版本、配置、路由和数据接口,支持熔断与供应商切换。
七、响应目标是识别所有派生制品并阻断继续信任
针对AI供应链攻击的应急响应一般包括确认、定位、遏制、验证、恢复以及协同六个步骤,在应急演练的时候,我们必须验证能不能在小时级回答“哪些系统正在使用受影响的组件”。
八、用透明度、完整性、可替代性和响应速度衡量成熟度
我们用“一旦出现供应链事件以后所导致的业务中断、数据暴露、错误决策和合规损失是不是持续下降的”衡量响应的效果。是,则说明这个响应是有效的,如果不是,说明这个响应是无效的。
九、国内外框架正在把供应链透明度转化为生命周期责任
我国《生成式人工智能服务管理暂行办法》要求使用合法来源的数据和基础模型;NIST将“价值链与组件集成”列为生成式AI风险;NTIA倡导数据表、模型卡、系统卡和独立评估。AI供应链治理趋势是,从原则性“可信”走向组件披露、独立评测、事件报告、变更管理与责任可追溯。
总的来说,AI供应链安全最终要证明“可信依赖能够产生可信结果”。我们需要看见完整链条,要绑定可验证的证据,随时准备变化与退出。清单让供应链可见,来源让制品可信,评测让行为可知,韧性让依赖可控。
我今天演讲到此结束,谢谢大家!
声明:本文来自中国信息安全,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
