大模型采用 MoE(Mixture-of-Experts,混合专家)架构,一个重要原因是它可以在不显著增加单次推理计算量的情况下,继续扩大模型参数规模。
但 MoE 在提升效率的同时,也引入了一个传统稠密模型没有的问题:模型每次真正执行哪些参数,不再完全固定,而是由 Router(路由器) 动态决定。
这件事对安全意味着什么?
如果模型的安全能力恰好集中在某些专家中,而攻击者通过提示词、恶意微调甚至直接修改模型权重,让这些专家不再被激活,那么模型虽然“拥有”安全能力,却可能根本没有机会使用它。
来自阿姆斯特丹自由大学的研究团队在论文 SEAL: Reinforcing Global Safety in Mixture-of-Experts through Shared Expert ALignment 中,将这一问题概括成 MoE 的一种结构性安全风险:模型的安全行为可能依赖于路由路径。
https://arxiv.org/pdf/2609.02293
他们由此提出了一个非常直接的思路:与其一直想办法保证 Router“选对专家”,不如寻找一个无论 Router 怎么选,每个 Token 都必须经过的位置,把安全能力放在那里。
这个位置,就是 Shared Expert——共享专家。论文已被 ACM CCS 2026 接收。
MoE 的问题:安全能力也会跟着“稀疏化”
在传统 Transformer 中,每一层通常包含 Attention 和 FFN(前馈神经网络)两部分。可以简单理解为:Attention 负责让不同 Token 之间交换信息,而 FFN 负责继续加工每个 Token 的内部表示。
MoE 做的事情,本质上是把原本的一个 FFN 换成很多个“专家 FFN”。
例如模型可能拥有 64 个专家,但对于当前 Token,Router 最终只选择其中 2 个:
Token → Router → Expert 3、Expert 17 → 输出
下一个 Token,则可能被分配到 Expert 5 和 Expert 21。
因此,模型虽然拥有大量参数,但每次真正参与计算的只是很小一部分。这也是 MoE 能够在控制计算成本的同时扩大模型容量的重要原因。
但这种结构也带来了一个新的问题。
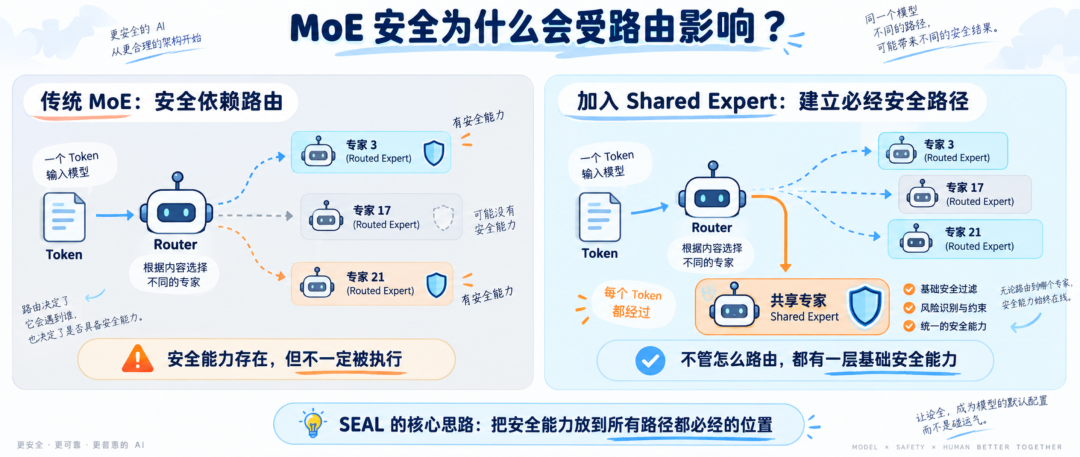
假设模型中负责识别危险请求、产生拒答行为的安全能力,比较集中地存在于 Expert 3 和 Expert 17。那么当正常请求到来时:
Router → Expert 3 + Expert 17 → 安全机制正常工作
但如果攻击导致路由发生偏移:
Router → Expert 5 + Expert 21 → 安全专家没有参与计算
模型内部的安全能力虽然并没有消失,却可能在这一次推理中被“绕过去”。
现有很多针对 MoE 的安全防御,也因此把注意力集中在 Router 上:让危险输入仍然被送到正确的安全专家,或者直接修复那些承担安全功能的 Routed Expert。
问题是,无论怎么加固,只要安全机制仍然依赖 Router,就存在同一个前提:
Router 必须可靠。
而 SEAL 想解决的,正是这个前提本身。
共享专家:MoE 中一个天然的“必经节点”
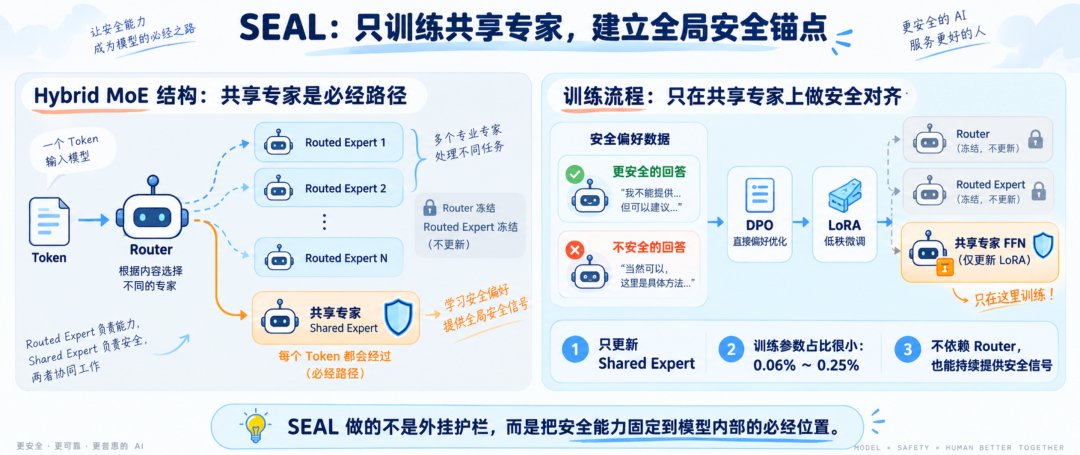
现代很多 MoE 已经不再是所有专家都由 Router 动态选择,而是采用一种 Hybrid MoE,也就是“混合式 MoE”。
其中存在两类专家:
一类是 Routed Expert(路由专家),只有 Router 选中后才会运行;
另一类是 Shared Expert(共享专家),不参与 Router 的竞争,而是对每一个 Token 都执行。
共享专家最初并不是为了安全设计的,它主要用于承载不同输入都会使用的通用能力,避免相同知识被重复存储在多个专家中。
但 SEAL 注意到了这个设计背后的安全价值:既然 Shared Expert 永远都会执行,那么它天然就是一个无法通过改变路由轻易绕开的控制点。
可以把整个 MoE 想象成一座办公楼。
Router 是前台,根据访客需求,把不同的人送到不同办公室。数学问题去数学专家,代码问题去代码专家,其他任务再去其他专家。
传统的 Router 安全方案,相当于要求前台:
“一定要把危险访客送到经过安全加固的办公室。”
SEAL 的思路则不同:
在所有人进入办公区之前,先设置一道所有人都必须经过的安检。
这里的“安检”,就是 Shared Expert。
因此,SEAL 并不是试图替代 Router,而是在 Router 之外增加一个路由无关的安全锚点:
Router 正常时,由 Router 和安全专家共同工作;
Router 被扰乱时,Shared Expert 仍然保留一层基础安全能力。
这使 MoE 的安全从单纯的“选对专家”,转向了一种更接近纵深防御的结构。
共享专家里真的存在安全能力吗?
这里还有一个关键问题。
Shared Expert 虽然每次都会执行,但如果它本身完全不承载安全相关表示,那么把它作为安全锚点也没有意义。
因此作者首先分析了四个 Hybrid MoE 模型,包括 Qwen1.5-MoE、DeepSeekMoE、GLM-4.7-Flash 和 Qwen3.5。
他们分别向模型输入危险样本和普通样本,比较不同神经元面对两类输入时的激活差异,从中识别与安全行为高度相关的 Safety-Critical Neurons,也就是“安全关键神经元”。
结果发现,安全神经元并不只存在于 Routed Expert 中,Shared Expert 同样包含相当比例的安全相关神经元。
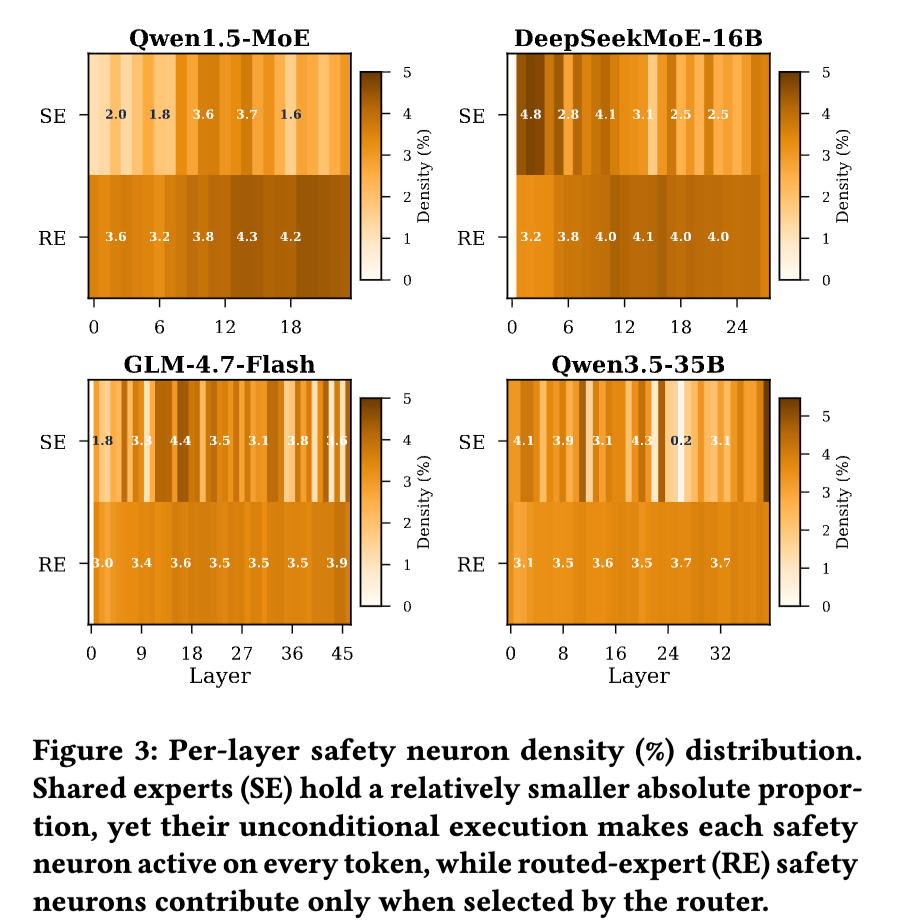
四个模型中,共享专家与路由专家的安全神经元密度比例分别约为 0.63、0.88、0.89 和 0.86。也就是说,虽然共享专家中的安全神经元密度通常略低,但已经处在相近量级。
更重要的是,两者的“执行覆盖率”完全不同。
一个 Routed Expert 中的安全神经元,只有 Router 选择这个专家时才能发挥作用;而 Shared Expert 中的安全神经元,每一个 Token、每一次前向计算都会参与执行。
这实际上引出了一个很值得注意的安全指标:
过去我们可能更关注:
模型哪里拥有最多的安全能力?
但对于 MoE 来说,还必须增加一个问题:
这些安全能力到底有多大的概率真正参与推理?
从这个角度看,共享专家虽然不是安全神经元最多的位置,却可能是安全能力执行最稳定的位置。
SEAL:只训练共享专家,把安全能力“钉”在必经路径上
基于这一观察,SEAL 的实现反而并不复杂。
作者没有重新训练整个模型,也没有修改 Router,而是只在每一层 Shared Expert 的 FFN 上增加 LoRA,并使用 DPO(Direct Preference Optimization,直接偏好优化)进行安全对齐。
训练数据包含约 4.1 万组人工标注的安全偏好样本,每组数据告诉模型:
面对同一个请求,哪一种回答更加符合安全要求。
关键在于:
训练产生的参数更新被限制在 Shared Expert 内部。
也就是说,SEAL 不是简单地“再做一次安全微调”,而是在有意识地选择安全能力存放的位置:
安全偏好 → LoRA → Shared Expert
Router 不动,Routed Expert 也不动。
这带来了两个直接好处。
首先,训练成本很低。在论文测试的四个模型上,真正需要训练的参数仅占总参数量的 0.06%~0.25%。例如 35B 参数的 Qwen3.5,实际训练参数只有约 1970 万。
其次,这些新增的安全能力不依赖 Router。无论一个 Token 最终被送到哪个 Routed Expert,它都会同时经过已经被安全强化的 Shared Expert。
因此,SEAL 真正做的不是简单“增加安全能力”,而是:
把安全能力固定到一个架构上保证必然执行的位置。
SEAL++:增强安全的同时,不要把原来的安全能力覆盖掉
在 SEAL 基础上,作者又设计了 SEAL++。
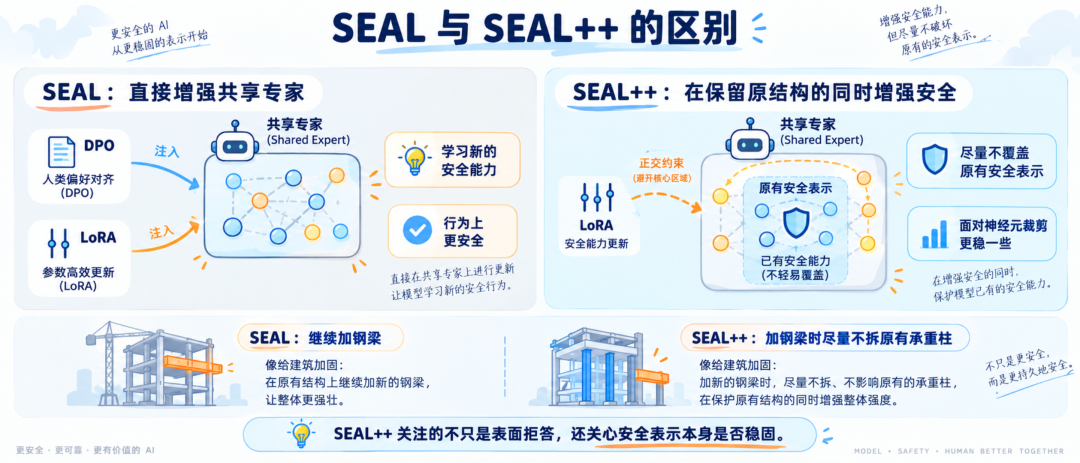
它试图解决另一个容易被忽视的问题:安全训练本身,也可能破坏模型原有的安全表示。
例如模型原本已经形成了一组负责识别危险内容的安全神经元,现在重新做 DPO 时,梯度不断修改这些参数。最终模型在行为测试上可能变得更安全了,但原来稳定的安全表示却可能被重写。
如果攻击者随后能够识别并裁剪少量安全神经元,这种重新组织后的安全结构依然可能变得脆弱。
因此 SEAL++ 在训练前先识别原模型中的安全关键神经元,并在 DPO 训练时增加一个正交约束。
不需要深入数学也可以理解:
新的安全能力可以继续学习,但尽量不要沿着原有安全能力所在的方向大幅改写参数。
就像在一栋已经存在承重结构的建筑中进行加固:
SEAL 更像是“继续增加钢梁”;
SEAL++ 则进一步要求:
增加新钢梁的同时,尽量不要拆掉原来的承重柱。
因此 SEAL++ 关注的不只是模型表面上的拒答行为,还希望提高安全表示本身面对神经元裁剪等权重级攻击时的稳定性。
实验结果
论文在 Qwen1.5-MoE、DeepSeekMoE、GLM-4.7-Flash 和 Qwen3.5 四种架构上进行了测试,并设计了三类不同权限的攻击场景:输入层面的危险提示和越狱、能够修改模型参数的恶意微调,以及直接识别并裁剪安全关键神经元的权重级攻击,同时还组合测试了“提示攻击 + 神经元裁剪”等复合场景。
在直接危险提示下,SEAL 的提升非常明显。
例如 DeepSeekMoE 的攻击成功率从 61.3% 降至 8.5%;GLM 从 20.7% 最低降至 1.8%;Qwen1.5 从 27.5% 降至 13.1%。Qwen3.5 原本的攻击成功率已经只有 5.8%,经过处理后仍进一步下降到最低约 1.1%。
与此同时,五个通用能力基准测试上的平均性能变化整体很小,论文报告的最大能力代价不超过约 1.4%。
但真正能够说明“全局安全锚点”价值的,并不是这些普通攻击,而是一个更有针对性的实验:
如果攻击者已经知道 Shared Expert 被加固,故意不攻击它,只攻击 Routed Expert,会怎么样?
以 DeepSeekMoE 为例,在“危险提示 + Routed Expert 神经元裁剪”场景中,原模型攻击成功率达到 74.2%。
加入 SEAL 后下降到 13.8%,SEAL++ 为 14.0%。
值得注意的是,在这个实验中,攻击者裁剪的是 Routed Expert,而 SEAL 从头到尾没有训练任何 Routed Expert 参数。
原因恰恰来自 Shared Expert 的结构特点。
即便 Routed Expert 中的部分安全能力已经被破坏:
被破坏的 Routed Safety + 仍然执行的 Shared Safety
共享专家依然会在每个 Token 上持续向模型隐藏状态注入安全信号,从而部分补偿其他专家中已经丢失的安全能力。
论文将这种现象称为 Cross-Scope Transfer(跨作用域迁移)。
也就是说:
加固的是 Shared Expert,但保护效果能够部分扩散到 Routed Expert 遭到攻击的场景。
这才是“全局安全锚点”这个概念真正成立的关键。
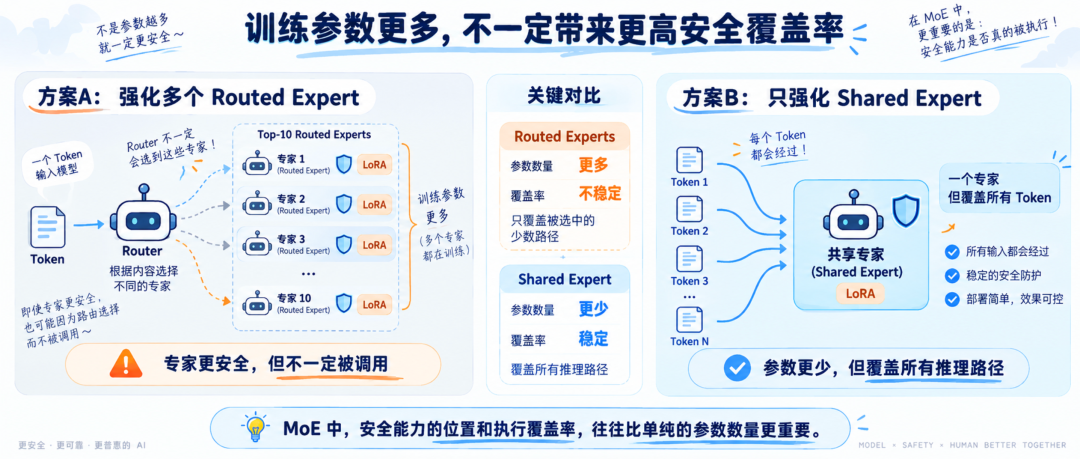
为什么不直接把几个最重要的 Routed Expert 训练得更安全?
一个很自然的问题是:
既然都是专家,为什么一定要训练 Shared Expert?
把安全性最高的几个 Routed Expert 找出来,然后重点强化它们,不也可以吗?
作者在 Qwen1.5 上专门进行了对比。
只训练安全得分最高的 Top-10 Routed Experts 后,普通危险提示的攻击成功率从 27.5% 降至 18.8%;而只训练 Shared Expert,则可以进一步降到 13.1%。
更值得注意的是,Top-10 Routed Experts 使用的训练参数量已经达到 Shared Expert 的 4~5 倍,效果却仍然更弱。
原因仍然是同一个:
Routed Expert 再安全,也必须先被 Router 选中。
共享专家则不需要等待 Router 做出正确选择。
因此,从这组实验可以得到一个比“哪个专家更安全”更加普遍的结论:
在 MoE 模型中,安全能力的价值不仅取决于它被存在哪里,还取决于它能否稳定参与每一次推理。
参数数量并不等于安全覆盖率。
局限性
SEAL 的实验同样暴露出了这条路线非常明确的边界。
首先,它对恶意微调只能提高韧性,无法真正保证模型安全不被破坏。
例如 DeepSeekMoE 在恶意微调后的攻击成功率,即使加入 SEAL 仍然达到 86.5%;Qwen1.5 也仍然超过 70%。因为恶意微调可以修改模型中大量其他参数,仅靠一个共享专家无法抵消整个模型被重新训练产生的影响。
论文因此特意区分了两个概念:
SEAL 提供的是 Resilience(安全韧性),而不是 Integrity(完整性保证)。
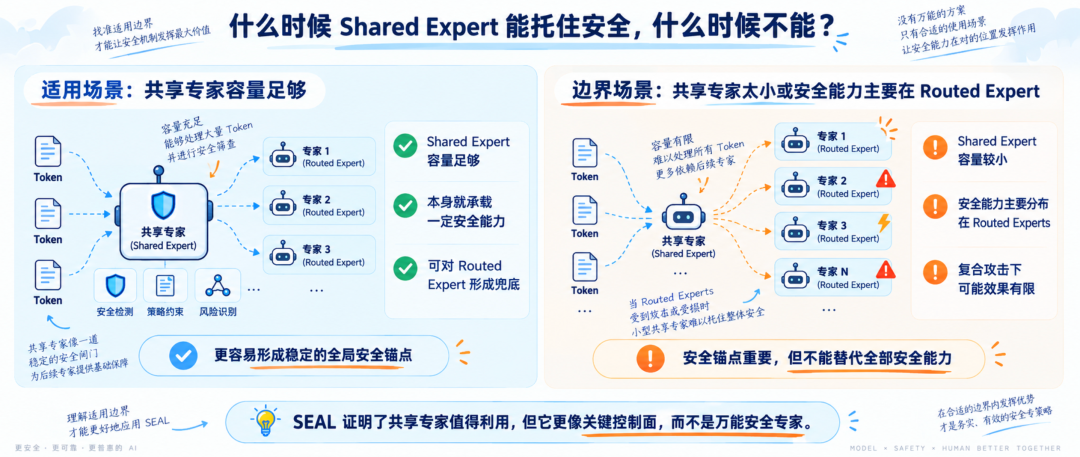
其次,SEAL 的效果高度依赖 Shared Expert 本身的容量以及安全能力在模型内部的分布。
Qwen3.5 就是一个典型反例。
它的 Shared Expert 中间维度只有 512,大约只有 Qwen1.5 的十分之一,而且更多安全能力分布在 Routed Expert 中。在某些“危险提示 + Routed Expert 裁剪”的复合攻击中,加入 SEAL 后攻击成功率反而从 5.9% 上升到 13.2%;SEAL++ 则达到 15.3%。
作者认为,这可能是因为 Shared Expert 容量过小,无法补偿 Routed Expert 被裁剪后损失的大量安全信号,同时共享专家训练又改变了部分内部激活和路由动态。
这说明一个很重要的问题:
Shared Expert 并不天然就是模型的“安全中心”。
它只是一个非常适合承载安全能力的位置。
如果模型本身几乎所有安全能力都分布在 Routed Expert,而 Shared Expert 又非常小,仅靠强化共享专家并不足以建立真正的全局防御。
此外,没有 Shared Expert 的 MoE 架构,例如经典 Mixtral,也不适用于 SEAL;论文目前只验证了四种架构,最大模型约 35B,更大规模模型上的效果仍然需要进一步验证。
从“保护 Router”到“寻找所有路径的必经节点”
如果只看具体技术,SEAL 使用的 DPO、LoRA、安全神经元识别都不是全新的方法。
这篇论文真正有价值的地方,是它换了一个观察 MoE 安全问题的角度。
过去很多研究面对路由攻击时,第一反应是:
Router 不可靠,那就保护 Router。
面对安全专家被绕过:
那就修复安全专家,并让 Router 尽量继续选择它们。
SEAL 则继续追问了一步:
有没有一个位置,不管 Router 怎么变化,所有 Token 都必须经过?
Shared Expert 恰好满足这个条件。
因此,它实际上把大模型安全中一个非常经典的系统安全思想带进了 MoE:
与其试图保证所有动态路径都不会出问题,不如寻找所有路径共同经过的控制点,并在那里建立一层独立的安全能力。
从这个角度看,Shared Expert 的价值已经不只是 MoE 为提升效率设计的“通用知识专家”,它还可能成为一种新的模型原生安全控制面。
Router 负责选择路径;
Routed Expert 负责专业能力;
Shared Expert 则可能承担一部分所有路径都必须执行的安全能力。
未来设计 MoE 时,“共享专家到底留多大”或许也不再只是一个模型效率和能力问题,还可能成为一个安全架构参数。
这也是 SEAL 最值得关注的地方:
它没有再给模型外挂一个新的安全检测器,而是试图从 MoE 自身的计算结构中,找到一个天然存在的、无法轻易被路由绕过的安全位置。
真正稳定的安全能力,不仅要存在于模型里,还要保证在需要它的时候,一定会被执行。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。