ANT:面向智能体行为审计的多粒度网络流量数据集与评测基准
ANT: A Multi-Granularity Network Traffic Dataset and Benchmark for Agents Behavior Auditing
AI智能体会调用模型、使用工具,并与外部环境交互。这些步骤会产生网络流量。即使通信内容经过加密,数据包的长度、方向和时间等特征仍可观察。那么仅根据智能体执行时产生的网络流量,能在多大程度上推断其任务与行为呢?
今天介绍的论文《ANT: A Multi-Granularity Network Traffic Dataset and Benchmark for Agents Behavior Auditing》,围绕这一问题构建了智能体网络流量数据集与评测基准。
论文原文:https://arxiv.org/abs/2610.06514
数据集:https://huggingface.co/datasets/benzenenene/ANT
数据采集系统与Benchmark代码:https://anonymous.4open.science/r/ant-main-suite-7BC0/
01
智能体网络流量特点
一次智能体任务的执行,包含模型调用、工具使用以及对返回结果的分析。论文以一次问答任务为例,展示这些执行活动如何与网络流量相对应。
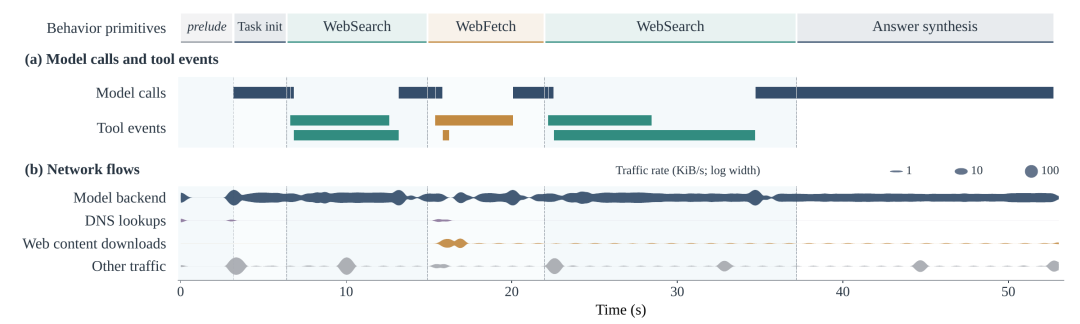
图1|问答任务中的行为原语、模型与工具事件,以及相应的网络流量
从执行语义看,这一过程可以划分为一系列“行为原语”。每个行为原语围绕一个相对完整的子目标展开,通常包含与模型后端的通信、调用工具,以及分析工具返回的结果。因此,一个行为原语所对应的流量,可能同时包含模型通信和工具操作带来的网络交互。
将上下两条时间线对齐,可以观察到:各个行为原语开始附近,往往伴随着网络流量的突发。 而随着子目标和所用工具发生变化,流量的组成与交互模式也呈现出差异。例如,在这个案例的WebSearch阶段,流量主要来自智能体与模型后端之间的通信。这与Harness的执行策略有关:它将搜索操作交给模型后端完成。到了WebFetch阶段,智能体需要获取指定URL的内容,因此又引入了DNS域名查询和网页内容下载流量。虽然两类行为都服务于信息获取,但它们在执行方式及相应的网络交互上存在区别。
从这个例子可以看到,智能体执行任务时,不同阶段的行为会在网络流量中留下相应的特征。为了研究这些特征能在多大程度上反映智能体的任务与行为,ANT将网络流量与执行记录对齐,既标注整次执行的任务,也标注其中各个阶段的行为。
02
ANT数据集构建
▌数据集概况
ANT数据集记录了3,114次智能体执行、276,417条双向流、104.07 GB网络流量。数据覆盖五种智能体配置、20类任务和五个场景:代码与数据工程、通用知识问答、科学证据评估、交互式应用操作,以及网络安全滥用。
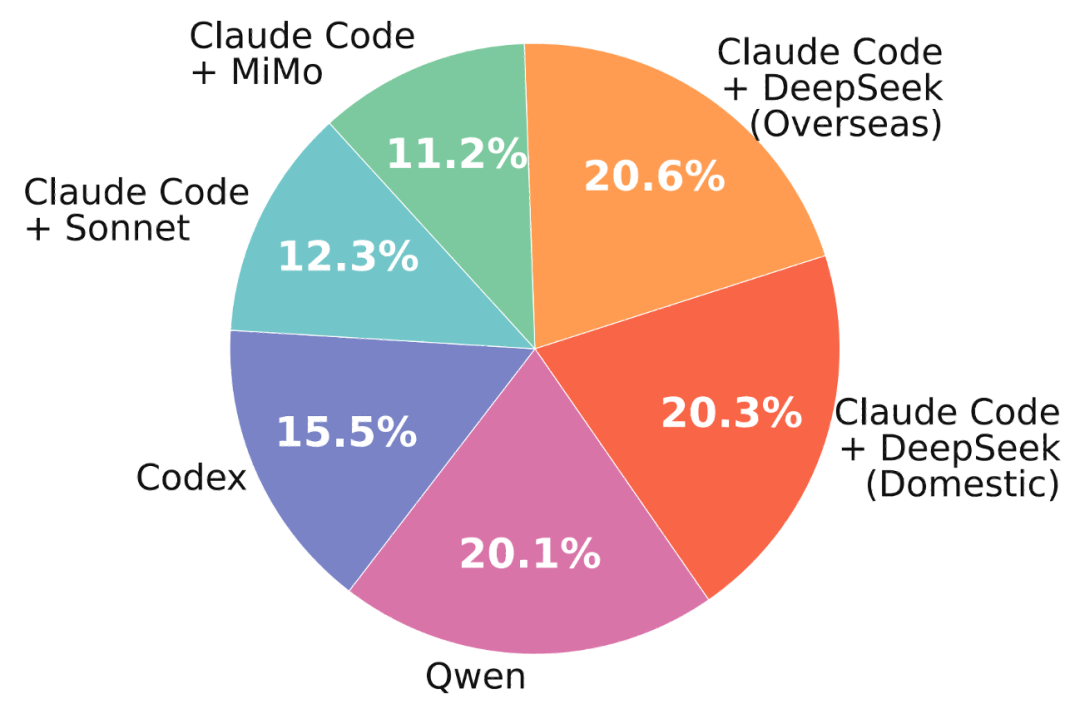
图2|ANT数据集中各智能体配置的执行样本占比
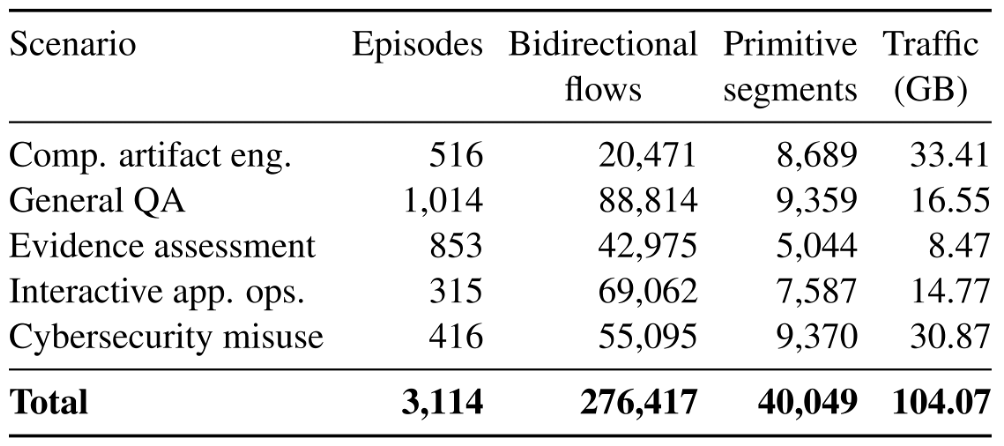
表1|ANT数据集各场景的数据规模统计
▌数据采集系统
研究团队在国内外两个云服务器上部署了自动化采集系统。每次执行前,系统先准备任务所需的工作目录和运行环境,再输入自然语言任务指令,启动智能体。智能体随后调用模型、使用网页搜索或Shell命令等工具,并根据返回结果继续决策,直至生成最终回复。整个过程中,系统同步记录模型调用、工具使用、工具输出及会话状态的时间戳,同时用tcpdump捕获全部收发数据包,保存为PCAP文件。执行日志与网络流量通过时间戳对齐,为后续划分行为原语片段提供依据。
为减少采集干扰,每个任务实例都在独立的虚拟网络命名空间中运行,避免并发任务的流量相互混杂。智能体只能访问当前工作目录和必要的运行环境,防止通过读取预存答案等方式绕过实际的网络检索。涉及状态变更的正常任务使用本地模拟服务,攻击执行则限制在隔离的Docker环境中,以保护采集服务器和外部生产系统。
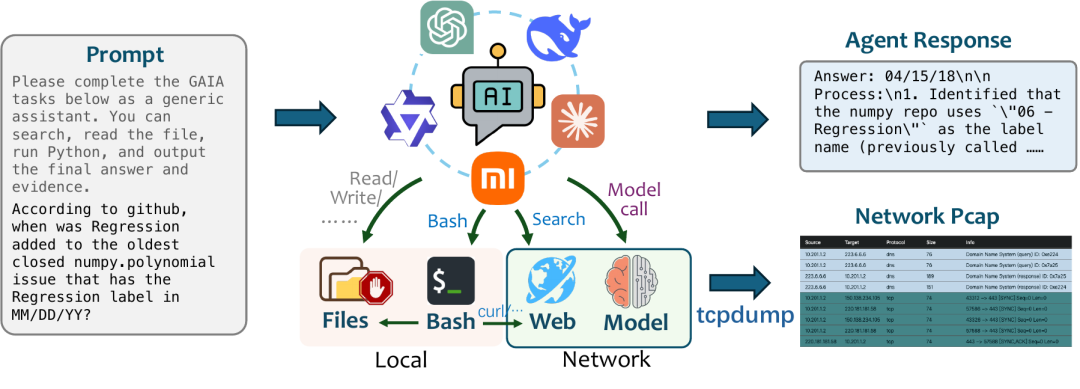
图3|智能体执行日志与网络流量的同步采集流程
▌行为原语标注
为了标注局部行为,研究团队根据会话日志中的起始时间划分流量片段,并从日志证据中提取“行为原语”,再通过Jina Embeddings v5和球面K-means聚类,将40,049个行为原语片段归并为47个宏观类别。
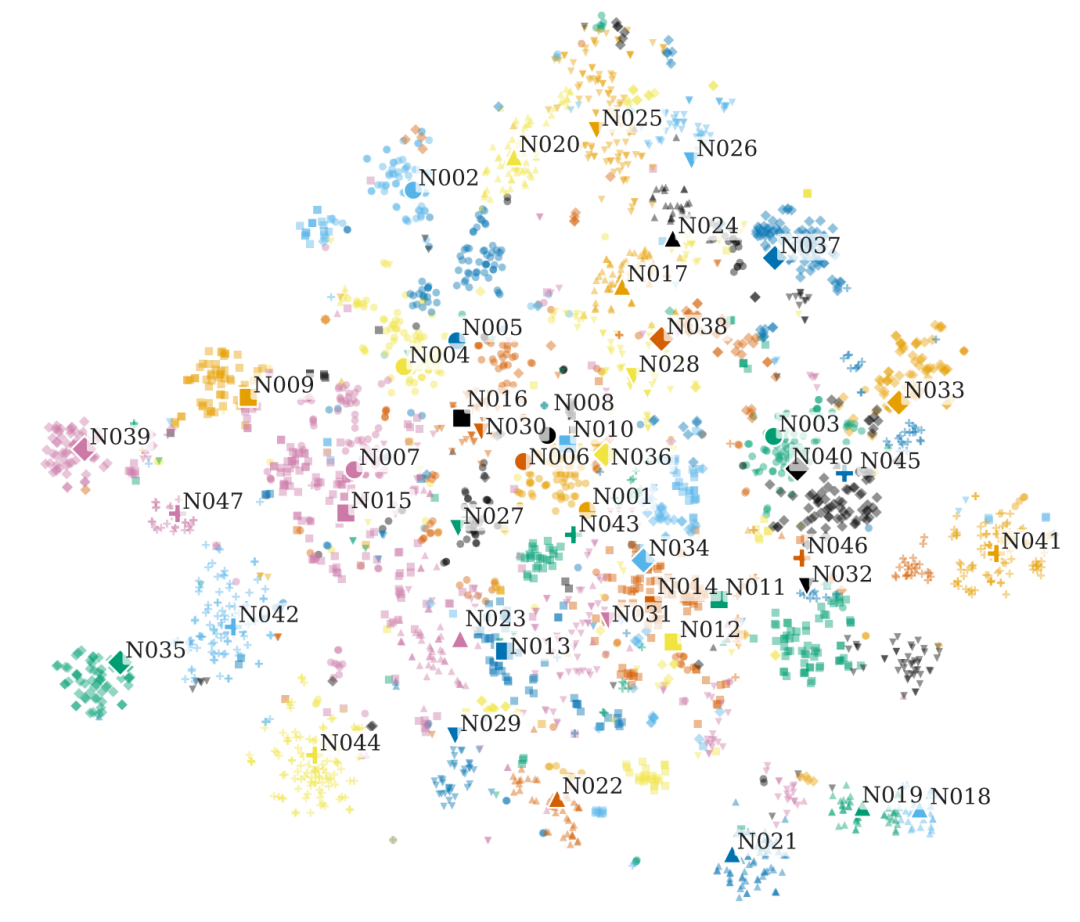
图4|47类行为原语聚类可视化
进一步的分析表明,行为原语的分布和顺序呈现出任务场景的特点。 同一场景下的不同任务,其原语语义分布和宏观类别比例更接近,相应距离比跨场景任务分别降低15.46%和14.79%。研究团队还保留原语的种类与数量,仅打乱执行顺序进行对照,发现真实序列具有更强的场景内相似性。
03
基准评测
为了研究网络流量能在多大程度上反映智能体的任务与行为,研究团队设计了三个由粗到细的评测任务:
风险识别:根据网络流量判断智能体活动是否具有恶意,为智能体滥用管控提供依据。
场景识别:根据一次完整执行的网络流量,判断智能体正在处理哪类任务,例如通用问答、科学证据评估或交互式应用操作。
行为原语分类:根据局部执行阶段的流量片段,识别智能体的具体行为,将其归入47个行为原语宏观类别之一。
研究团队选取了13种加密流量分类与网站指纹识别方法,比较它们在这三个任务中的表现。
▌风险识别:对内容层面滥用检测能力有限
论文评测了13种流量分析方法。评测结果表明,所有流量分析方法整体准确率都超过90%,但其中七种方法对恶意类别的召回率低于50%。
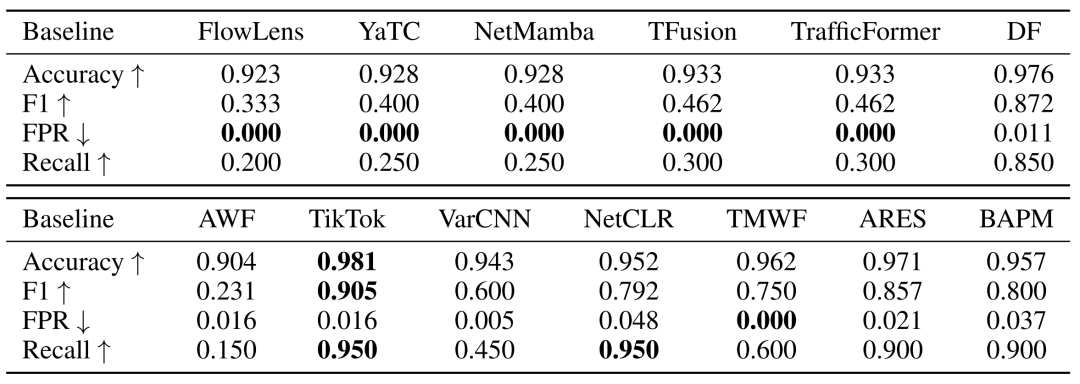
表2|风险识别评测结果
进一步拆分任务后,差异更加明显。Web渗透包含扫描、SQL注入和XSS等直接网络交互,留下了较明显的流量线索。相比之下,恶意代码生成和沙箱规避的风险更多体现在代码内容与执行意图中,其可观察流量与正常代码任务更相似。YaTC、NetMamba、TFusion和TrafficFormer对后两类任务的检出率相当低,而对Web渗透的检出率接近1。
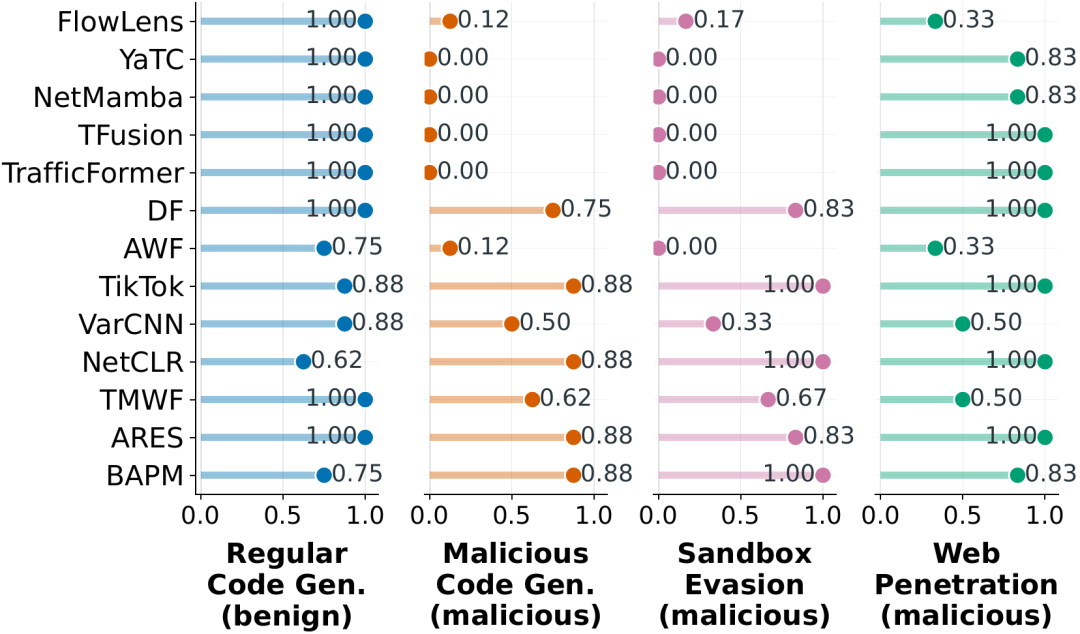
图5|各方法对正常代码生成及三类恶意任务的识别结果
▌场景识别:相似任务容易混淆
在五类场景识别中,13种方法的准确率为43.1%至72.7%,NetMamba取得最高准确率。通用知识问答与科学证据评估是主要混淆来源:二者都包含检索、推理和答案生成。汇总各基线预测结果,35.1%的科学证据评估样本被判为通用知识问答,22.8%的通用知识问答样本被判为科学证据评估。
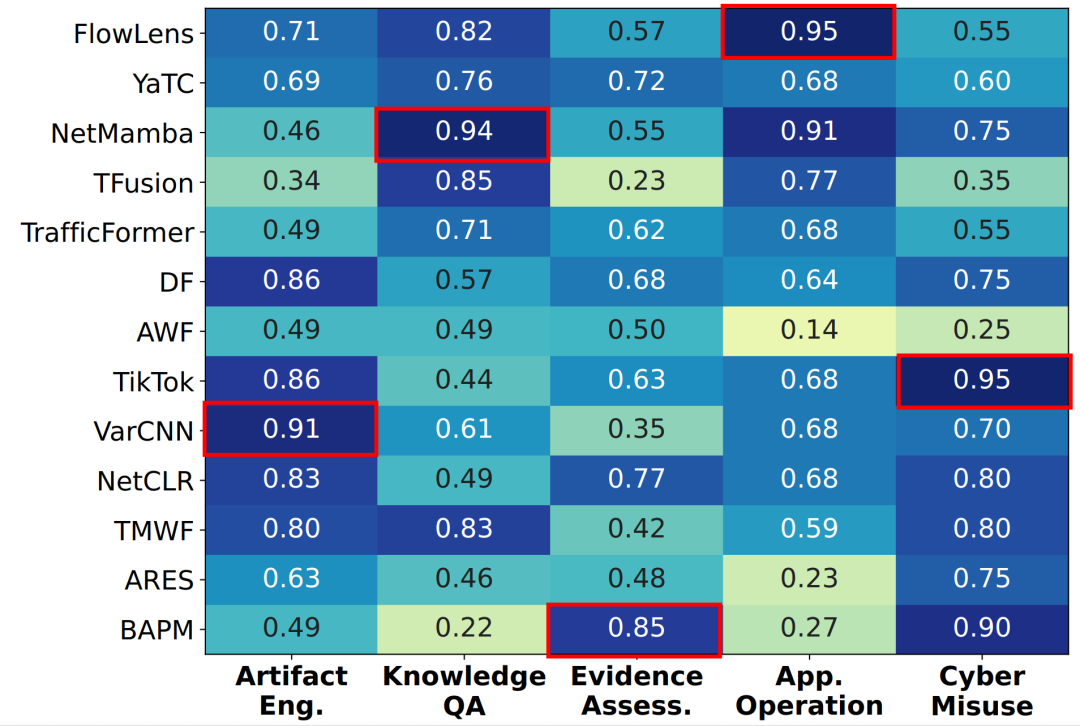
图6|场景识别召回率
研究团队进一步研究场景识别依赖哪些流量。相较于完整流量,仅保留模型调用流量时,平均准确率提高5.56个百分点;去掉这部分流量后,平均准确率下降4.31个百分点,但仍约为54.7%。这说明模型调用承载了较强的场景信号,其他流量也包含有用信息。团队还比较了移除代表性与非代表性行为原语流量的影响,平均准确率分别下降6.95和3.77个百分点。代表性片段被移除后带来的更大降幅表明,与任务语义紧密相关的局部行为也为场景识别提供了重要线索。
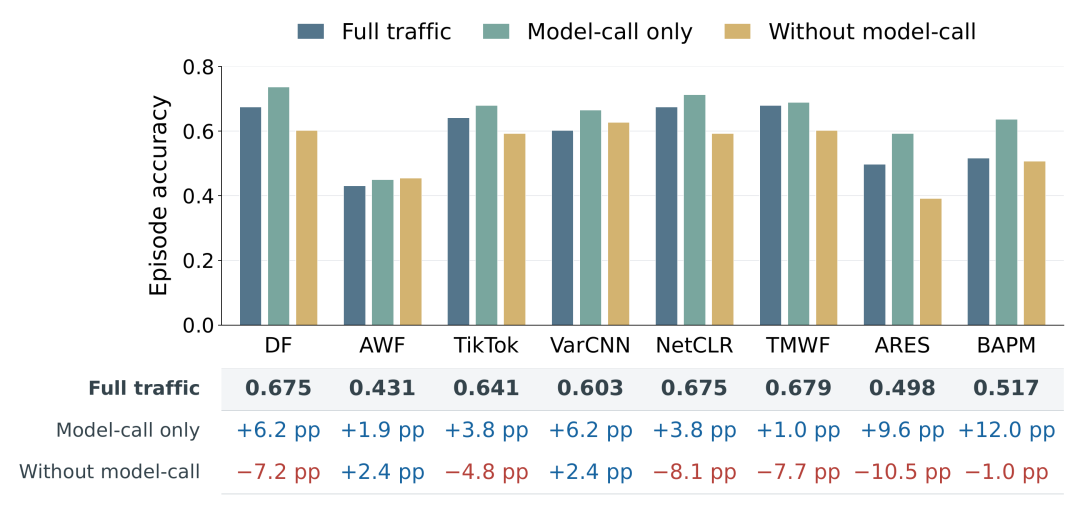
图7|完整流量、仅模型调用流量、去除模型调用流量下的场景识别准确率
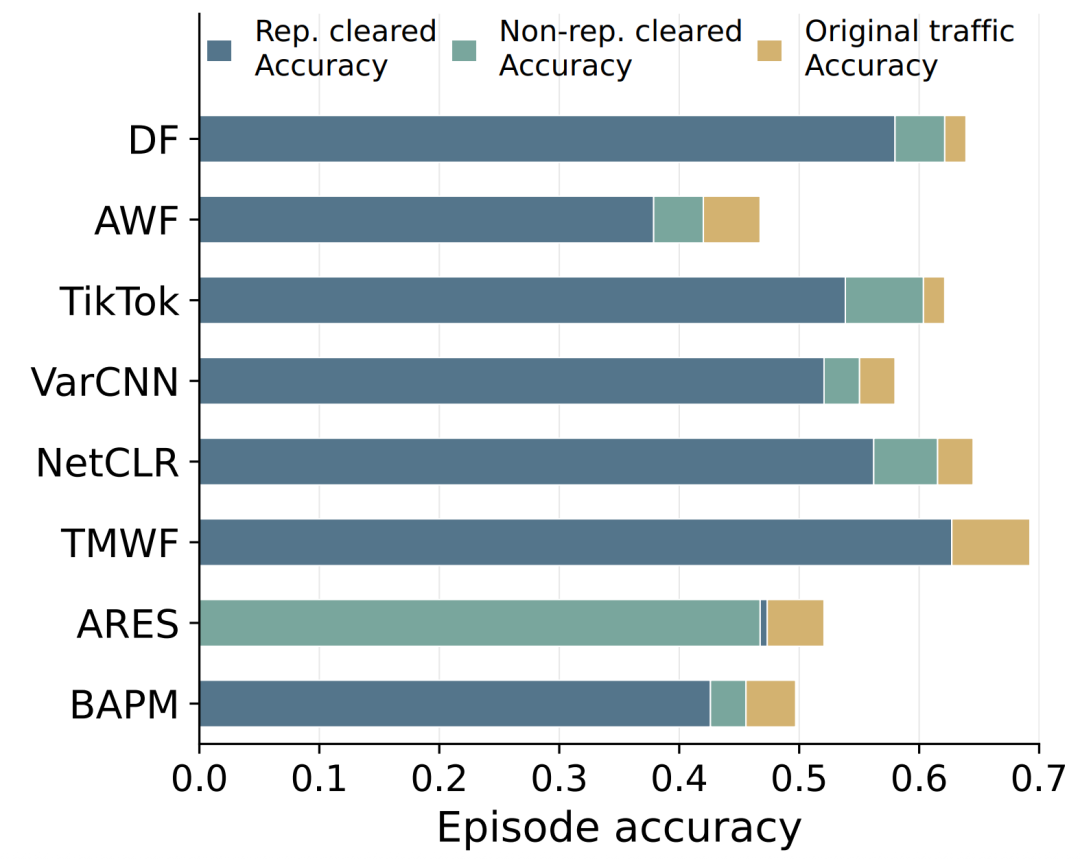
图8|移除代表性与非代表性行为原语流量对场景识别准确率的影响
▌行为原语分类:常见类别更容易识别
行为原语分类要求模型仅根据某个片段的流量,将其归入47个宏观类别。八种方法的准确率为35.5%至46.2%。频率最高的十类占测试片段的72.44%,却贡献了各模型91.34%至96.09%的正确预测。搜索、网页抓取与API查询等相近类别也存在混淆。
评测结果表明,现有方法对常见类别,以及流量模式较鲜明的类别,识别得更可靠;稀有类别和语义相近的类别仍然困难。
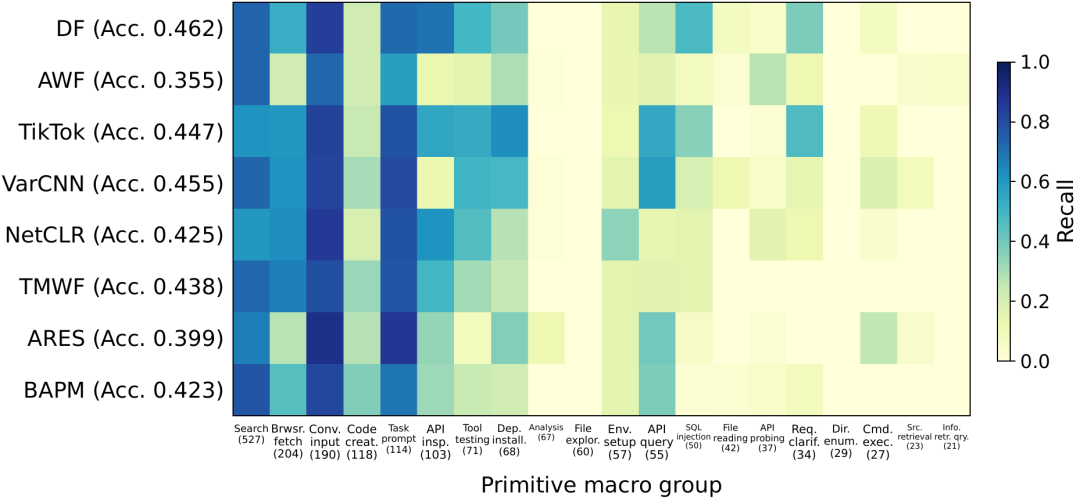
图9|行为原语类别的召回率
04
结语
这项工作将智能体网络流量与任务元数据、行为原语标注相结合,为流量分析方法在智能体流量上的表现提供了评测基准。实验结果显示,现有方法能够捕捉鲜明的流量模式,但对稀有行为,以及未充分体现在流量中的语义差异,仍然难以准确识别。通过将这些识别结果与具体执行行为对应起来,ANT为后续研究更精细的网络侧智能体行为审计与取证方法提供了基础。
声明:本文来自赛博新经济,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
