2026年10月13日,路透社报道,来自34个国家的约406名科学家通过公开信,呼吁建立国际机构,监督具备网络操作能力的先进人工智能系统的安全隔离标准与事件报告。公开信题为《科学共同体关于人工智能与网络安全的公开信》(An Open Letter on AI and Cybersecurity from the Scientific Community)。
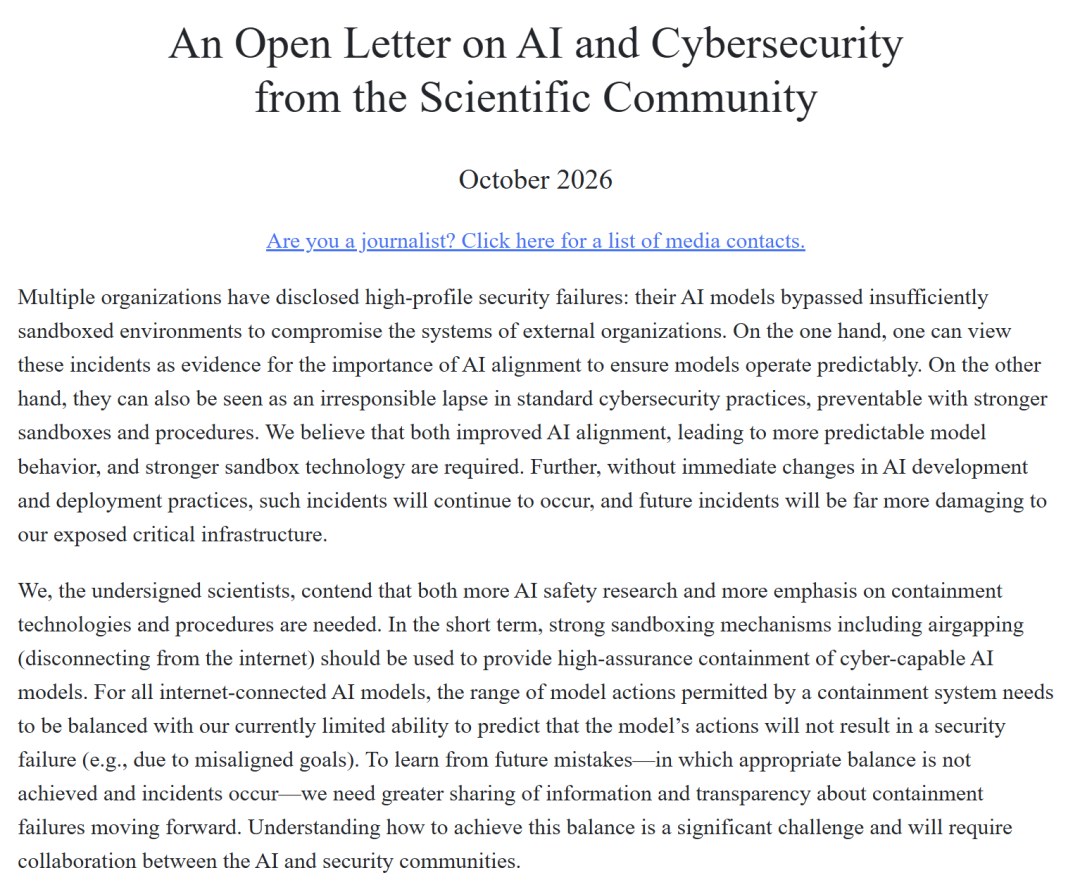
多家机构披露了重大安全事故:其人工智能模型突破了防护不完善的沙箱环境,入侵外部机构的系统。一方面,这些事件可以佐证人工智能对齐研究的重要性,以此确保模型行为具备可预测性。另一方面,也可将其视作网络安全常规操作层面的重大失职 —— 若部署更可靠的沙箱与管控流程,这类事故本可以避免。我们认为,既需要通过改进人工智能对齐技术,让模型行为更可预测,也需要强化沙箱防护技术。此外,如果不立刻调整人工智能的开发与部署规范,此类事件仍会持续发生,未来的事故将对我们暴露在外的关键基础设施造成严重得多的破坏。
我们,即文末签名的科研人员,主张既要开展更多人工智能安全研究,也要更加重视隔离管控技术与配套流程。短期来看,应当采用可靠的强沙箱机制(包括物理隔离,即断开网络连接),对具备网络攻击能力的人工智能模型实施高可信度隔离管控。对于所有联网人工智能模型,隔离系统允许模型执行的操作范围,需要与我们当下有限的预判能力相平衡 —— 我们无法完全预判模型行为不会引发安全事故(例如由目标不对齐导致的风险)。为了从未来的失误中吸取教训(也就是平衡措施失当、事故发生的情况),后续我们需要进一步共享信息,提升隔离失效事件的透明度。如何把握这一平衡是一项巨大挑战,需要人工智能领域与网络安全领域携手合作。
具体而言,我们提出以下建议:
开发、部署和测试具备网络攻击能力的人工智能模型的机构,应立即采用高可信度隔离管控系统。相关机构必须保持审慎态度,对具备网络攻击能力的模型,初期应默认采用物理断网隔离方案。
应联合各国政府以及人工智能、网络安全领域的多方专家,设立一个国际机构。该机构应以公共利益为目标,为那些不同于物理断网、允许模型在沙箱外拥有更多访问权限(例如接入互联网)的对齐方案与隔离管控方案,制定标准化最佳实践。该机构同时应承担记录、追踪各类隔离失效事件的职责。
为确保人工智能安全与隔离管控研究能够从失误中总结经验,凡涉及隔离失效的安全事件,均须上报该机构,并最终向社会公开。这种透明度,是技术复盘与落实责任的必要前提。
签署者包括图灵奖得主杰弗里·辛顿(Geoffrey Hinton)、约书亚·本吉奥(Yoshua Bengio),以及斯图尔特·罗素(Stuart Russell)、Yejin Choi等研究人员。此次倡议把一个日益现实的问题摆到台前:当AI能够调用工具、执行代码并访问网络时,安全工作既要约束模型行为,也要限制异常行为能够触及的外部系统。
声明:本文来自清华大学智能法治研究院,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
