随着大模型从对话工具逐渐演化为能够自主规划、调用工具、访问数据并改变外部环境的 Agent,AI 安全所面对的问题也在发生变化。
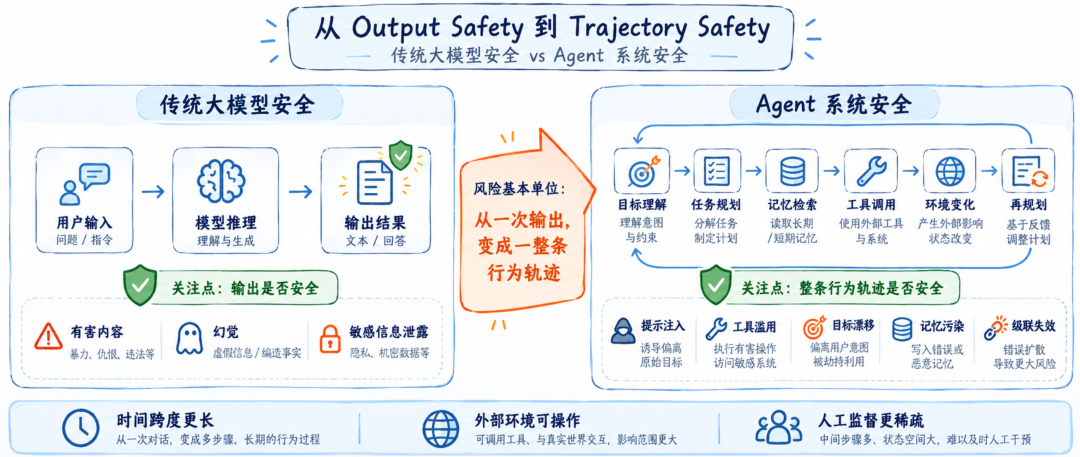
过去,大模型安全更多关注模型“输出了什么”:是否产生有害内容、是否泄露敏感信息、是否受到越狱攻击。但在 Agent 系统中,风险的基本单位正在从一次模型输出,扩展为一整条行为轨迹。一次错误判断可能进一步影响任务规划、记忆写入、工具调用和环境状态,并在后续执行过程中持续放大。
近期论文《Trustworthy Agentic AI: Failure Modes, Mitigation Strategies, and a Lifecycle Framework for Autonomous LLM Systems》提出了一套面向 Agent 系统的可信开发生命周期框架——TADL(Trustworthy Agent Development Lifecycle)。
https://arxiv.org/pdf/2609.22712
这套框架并没有提出新的攻击方法,也没有通过实验验证某一种防御技术,而是试图回答一个更基础的问题:
一个 Agent 从需求设计、系统开发到正式运行,安全究竟应该在哪些阶段介入?每个阶段需要留下什么证据,又需要满足什么条件才能进入下一阶段?
作者给出的答案,是一套由六个生命周期阶段、五道 Trust Gate,以及持续再评估机制组成的 Agent 安全工程框架。
Agent 安全正在从“模型安全”转向“系统安全”
传统大模型的基本交互模式相对简单:
用户输入 → 模型推理 → 输出结果。
即便模型产生错误,大多数情况下仍然需要人来读取结果并决定是否采取行动。
Agent 则不同。一个典型的 Agent 任务可能包含目标理解、任务拆解、记忆检索、网页访问、工具调用、代码执行、环境反馈和重新规划等多个环节。在这一过程中,模型不再只是生成文本,而是在持续改变系统状态。
因此,同样一次模型错误,在 Agent 中可能形成如下链条:
错误理解 → 错误规划 → 错误工具调用 → 环境状态变化 → 基于错误状态继续规划。
这使得 Agent 安全出现了几个明显变化:任务运行时间更长、能够触达更广泛的外部环境、人工监督频率下降,同时还可能涉及多个 Agent、多个用户和多个系统之间的交互。
因此,传统依靠 RLHF、内容审核和提示词防御构建的安全机制仍然重要,但已经不足以覆盖完整的 Agent 风险面。
作者将这种变化概括为五个主要可信维度:安全与鲁棒性、对齐与人工监督、透明与可审计性、隐私与数据治理,以及治理与合规。
但论文真正想解决的并不是如何重新分类这些风险,而是进一步追问:
这些风险应该在 Agent 生命周期的什么位置解决?
TADL:把安全嵌入 Agent 的整个生命周期
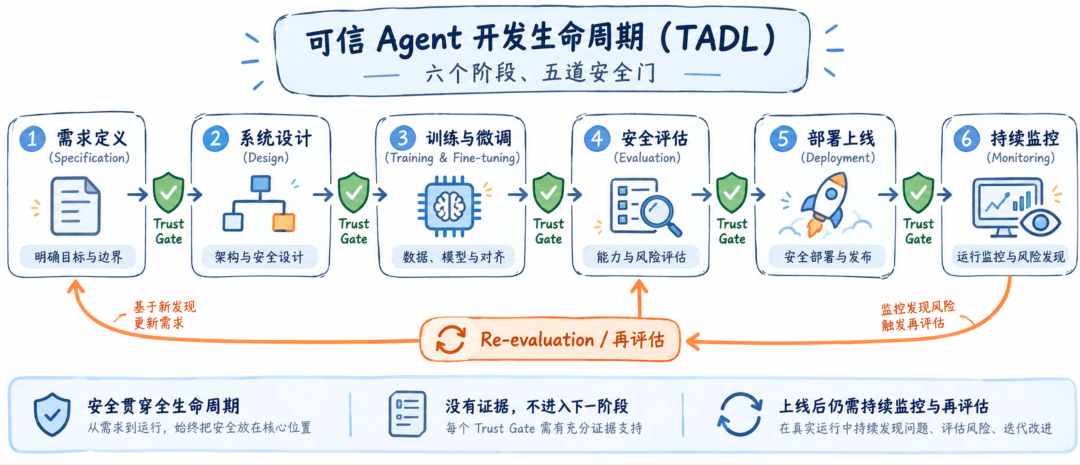
作者提出的 TADL 将 Agent 开发过程划分为六个阶段:
Specification → Design → Training & Fine-tuning → Evaluation → Deployment → Monitoring
即:
需求定义 → 系统设计 → 训练与微调 → 安全评估 → 部署上线 → 持续监控。
这套框架表面上与传统软件开发生命周期并没有太大区别。真正重要的变化在于,作者没有把安全评估单独放在上线之前,而是要求安全控制贯穿整个开发过程。
每两个阶段之间设置一道 Trust Gate(可信安全门)。只有满足当前阶段的安全要求,并形成相应的证据材料,系统才能进入下一阶段。
因此,TADL 实际上形成了一套:
阶段 → 安全要求 → 证据 → Gate → 下一阶段
的控制机制。
Agent 不再是“开发完成之后再做一次安全测试”,而是在生命周期中的每一个关键节点接受安全检查。
第一阶段:Specification
先定义 Agent “应该做什么”
TADL 的第一个阶段不是训练模型,也不是设计 Prompt,而是定义 Agent 的任务边界。
作者认为,很多 Agent 风险并不是来自模型能力不足,而是在项目最初阶段就没有明确回答几个基本问题:
这个 Agent 服务谁?允许做什么?不能做什么?能够访问哪些资源?哪些行为必须经过人工确认?如果多个主体的要求发生冲突,Agent 应该优先听谁的?
因此 Specification 阶段需要明确至少四项内容。
第一是 Scope,即 Agent 的能力边界。例如一个企业邮件 Agent 可以读取邮件和生成回复草稿,但是否允许直接发送邮件,是完全不同的风险等级。
第二是 Principal Hierarchy,也就是权限主体之间的优先级关系。现实中的 Agent 往往同时受到模型提供商、应用开发者、企业管理员和最终用户的影响。如果员工要求 Agent 将公司文件发送到私人邮箱,那么“用户指令”和“企业安全策略”之间就会发生冲突。
Agent 对齐因此不再只是传统意义上的“Human-AI Alignment”,而逐渐变成一种 Multi-principal Alignment:Agent 到底代表谁,并且在不同主体的利益发生冲突时应该如何决策。
第三是 Threat Model。需要提前明确 Agent 面临的风险,包括提示注入、工具滥用、记忆污染、敏感数据泄露、权限绕过以及长期目标漂移等。
第四是确定 Agent 的 Risk Tier,即风险等级。这一阶段最终需要形成风险评估、威胁模型、任务边界以及合规要求等基础文件,为后续设计提供约束。
换句话说,第一阶段不是告诉 Agent“怎么做”,而是先规定它“能做什么”。
第二阶段:Design
把安全落实到系统架构
进入 Design 阶段后,安全开始从原则转化为具体的系统机制。
这一阶段最关键的问题,是 Agent 拥有哪些权限,以及这些权限如何受到约束。
作者特别强调了几类设计机制。
首先是 Tool Permission Matrix,即工具权限矩阵。传统 Agent 开发中,经常简单地给模型接入一组工具,然后由模型自主决定何时调用。但从安全角度看,不同操作的风险完全不同。
例如一个代码 Agent 可能拥有:
工具 | 读取 | 写入 | 删除 | 是否需要审批 |
|---|---|---|---|---|
Git 仓库 | ✓ | ✓ | × | 合并需要 |
数据库 | ✓ | × | × | - |
云环境 | ✓ | ✓ | × | 修改配置需要 |
邮件系统 | ✓ | ✓ | × | 发送需要 |
这种设计实际上正在让 Agent 安全越来越接近传统 IAM:身份、角色、权限、策略和操作之间形成明确的控制关系。
其次是 Memory Governance。Agent 的长期记忆能够提高任务连续性,但同时也会扩大隐私和安全攻击面。系统需要明确哪些信息允许写入长期记忆、保存多久、谁可以读取,以及不同用户、不同任务之间是否允许共享。
第三是 Human Oversight。人工监督不能简单理解为“每一步都人工确认”。真正需要设计的是不同风险等级操作对应什么级别的审批机制:低风险操作可以自动执行,高风险操作则必须进入人工审批流程。
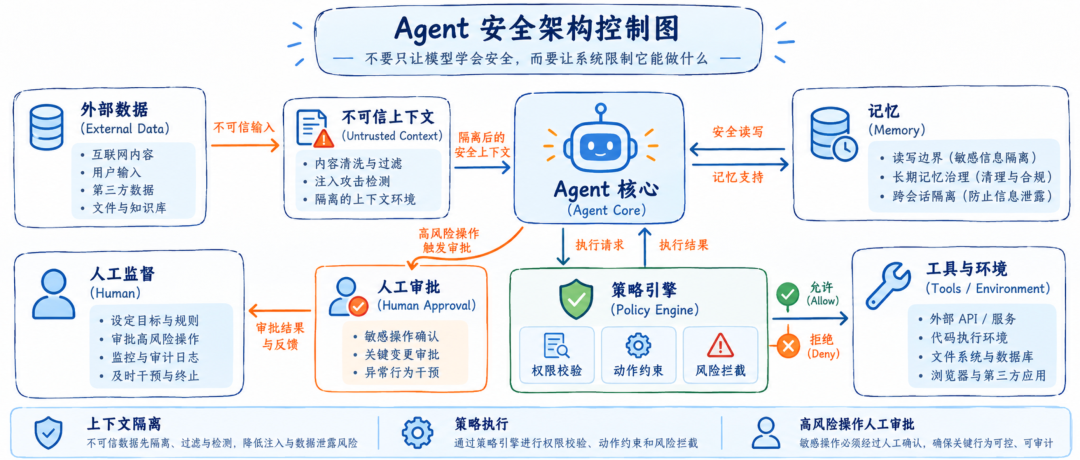
此外,还包括隐私控制、沙箱、上下文隔离、工具调用约束和策略执行引擎等机制。
这个阶段的核心思想是:
不要只要求模型学会安全,而要让系统架构本身限制 Agent 能够做什么。
第三阶段:Training & Fine-tuning
训练的不只是能力,还有行为边界
第三阶段进入模型训练和微调。
对于 Agent 而言,训练阶段的安全目标不仅是减少有害输出,还需要提升模型在复杂任务中的目标保持、指令优先级识别以及异常环境下的鲁棒性。
论文讨论了 RLHF、Constitutional AI、Process Reward Model 等已有方法,但同时强调了一个现实问题:当前大多数对齐技术的验证环境仍然以相对短期、可验证任务为主。
Agent 则可能持续运行数小时甚至数天,并且不断根据环境反馈重新规划。
这意味着 Agent 面临一个更加困难的问题:
Long-horizon Alignment。
模型在每一步可能只产生很小的偏差,但经过几十甚至上百次规划和行动之后,最终行为可能已经明显偏离最初目标。
因此,训练阶段需要关注的不只是“单步正确率”,还包括目标保持能力、工具使用偏好、风险行为倾向以及面对冲突指令时的决策模式。
同时,作者要求训练阶段保留数据来源、训练方法、安全对齐策略和模型版本等完整记录。
这些记录随后会成为 Evaluation 阶段的重要证据。
第四阶段:Evaluation
不只是测 Agent 能不能完成任务
Evaluation 是整个生命周期中最接近传统 AI 安全评测的一环,但论文对评测目标进行了明显扩展。
目前 Agent Benchmark 大量关注的是 Capability:Agent 是否能够完成网页操作、代码修改、任务规划或软件开发。例如 SWE-bench、WebArena 和 AgentBench,本质上都在回答Agent 有多能干?
但可信 Agent 评测需要回答另一个问题:Agent 在完成这些任务时是否安全、稳定、可控?
作者将这种差距称为 Capability–Trust Gap。
因此,Agent Evaluation 应覆盖提示注入、工具滥用、隐私攻击、目标偏移、多 Agent 交互以及长周期任务稳定性等场景。
尤其重要的是,评估对象不能只停留在单轮模型输出。
对于 Agent,更合理的评测单位应该是一整条执行轨迹:
目标理解 → 任务规划 → 信息检索 → 记忆调用 → 工具调用 → 环境变化 → 再规划。
也就是说,Agent 安全评测正在从 Output Safety 转向 Trajectory Safety。
TADL 要求这一阶段输出红队测试报告、基准测试结果、失效模式分析、隐私审计报告以及剩余风险清单等 Evidence Artifact。
如果仍然存在未解决的 Critical Failure,则不能通过对应的 Trust Gate。
第五阶段:Deployment
上线不是一个时间点,而是一个过程
传统软件经常将部署理解为从测试环境直接进入生产环境。对于高自主 Agent,作者认为这种模式风险过高,TADL 建议采用分阶段部署:
Sandbox → Limited User → Limited Capability → Staged Rollout → Production
即从沙箱环境开始,逐步开放用户、能力和权限,这一过程需要同时配置运行监控、异常检测、事件响应和回滚机制。
一个重要原则是:Agent 的能力开放程度应该与安全证据同步增加。
例如在早期阶段,Agent 可以拥有数据读取能力,但不开放写入;可以生成邮件,但不能自动发送;可以生成代码修改建议,但不能直接合并代码。
只有经过实际运行验证之后,才逐渐提升自主权限。
因此,部署本身也成为一种安全控制方式,而不再只是工程上线流程。
第六阶段:Monitoring
上线之后,Agent 仍然处于安全评估中
对于传统模型产品,上线往往意味着安全评测工作的结束,TADL 则将 Monitoring 作为生命周期中的正式阶段。原因在于 Agent 是一个高度动态的系统,即便模型本身没有发生变化,以下任何因素都可能改变系统风险:
工具 API 发生变化、外部网站结构变化、长期记忆持续积累、企业权限调整、Agent 接入新的工具、模型版本升级,或者出现新的攻击方法。
因此,过去的安全评估结果并不能永久有效。
Monitoring 阶段需要持续记录 Agent 的行为轨迹、异常调用、策略拒绝、人工干预以及安全事件,并根据风险变化决定是否重新进入 Evaluation,甚至重新回到 Specification 和 Design 阶段。
最终,TADL 并不是一条直线:
Specification → Design → Training → Evaluation → Deployment → Monitoring
而是形成一个持续循环:
Monitoring → Re-evaluation → Design / Specification → 再部署。
这也是 TADL 与传统“一次性安全评测”最大的区别。
五道 Trust Gate
没有证据,就不能进入下一阶段
如果说“六阶段”构成了 TADL 的骨架,那么 Trust Gate 才是这套框架真正的控制机制。
作者要求每个关键阶段结束后进行一次可信性判断。
例如:
Specification 完成后,需要确认威胁模型和风险等级是否明确;
Design 完成后,需要确认权限、记忆、隐私和人工监督机制是否已经实现;
Training 完成后,需要确认训练数据、模型版本和安全对齐过程是否可追溯;
Evaluation 完成后,需要确认关键安全问题是否已经解决;
Deployment 之前,需要确认监控、事件响应和回滚机制是否准备完成。
只有达到要求,才能进入下一阶段。
这里有一个很重要的设计:
Trust Gate 的判断必须建立在 Evidence Artifact 上。
不能简单写一句“经过安全测试”,而是需要对应的测试报告、风险清单、权限矩阵、数据来源、日志和审计记录。
换句话说,TADL 试图把 Safety Principle 转化为 Safety Evidence。
这使 Agent 安全第一次更接近传统安全工程和合规审计的思路。
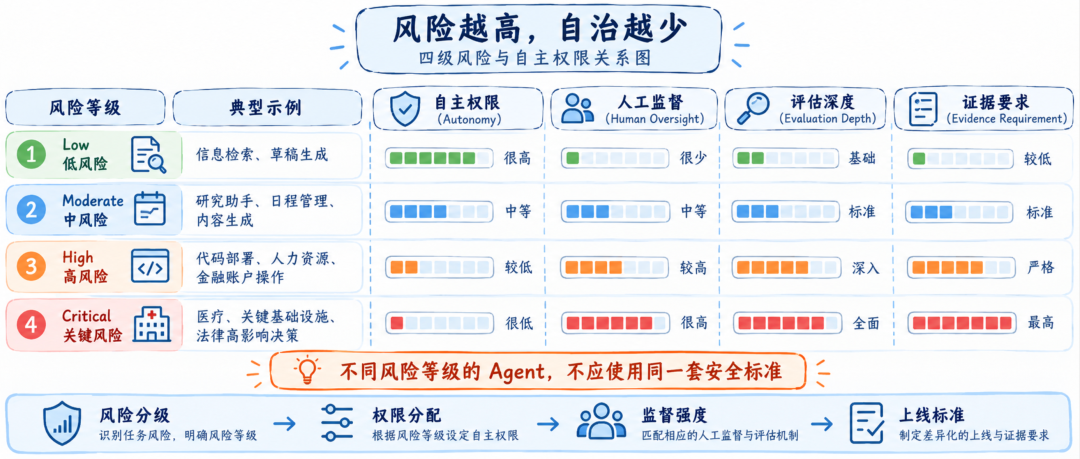
四级风险
不同 Agent,不应该使用同一套安全标准
TADL 还引入了 Risk-based Autonomy,即根据 Agent 风险等级决定其自主程度和安全要求。
论文大致划分为四个等级:
Critical、High、Moderate 和 Low。
Critical 对应可能产生严重甚至不可逆影响的 Agent,例如医疗、关键基础设施或部分法律决策场景。
High 可能造成重大影响,但通常仍然可恢复,例如代码部署、人力资源管理和金融账户操作。
Moderate 包括内容生成、研究助手和日程管理等任务。
Low 则主要是信息检索、人工审核后的文本草稿等容易验证的场景。
风险等级越高,Agent 应拥有越低的默认权限、更强的人工监督、更严格的安全评估以及更完整的 Evidence Artifact。
这种思路本质上是在反对当前 Agent 开发中的一个常见问题:
不同风险等级的 Agent,使用几乎相同的安全开发流程。
一个只能检索资料的 Agent,与一个可以修改生产数据库的 Agent,显然不能采用同样的自主权限和上线标准。
Prompt Injection 为什么越来越像一个架构问题
论文还讨论了 Agent 时代非常典型的安全问题——Prompt Injection。
很多 Agent 的上下文实际上是将多类信息直接拼接在一起:
System Prompt + User Instruction + Web Content + Email + RAG Document + Tool Result。
对于大模型而言,这些内容最终都会转换为 Token。
因此,系统指令与外部数据虽然在人类看来性质完全不同,在模型内部却并不存在天然的物理隔离。
这也是为什么传统方法,包括 Instruction Hierarchy、Spotlighting 和 Prompt Injection Detection,虽然能够降低风险,却很难从根本上解决问题。
更强的防御思路正在逐渐转向两类机制:
一类是 Context Isolation,尽可能隔离可信指令与不可信数据;
另一类是 Runtime Enforcement,即不再完全依赖模型自行判断某个行为是否安全,而是在 Action Layer 增加独立的 Policy Engine。
结构从:
LLM → Tool
变成:
LLM → Action Proposal → Policy Engine → Allow / Deny → Tool。
这样,即使模型受到提示注入影响,只要最终行为违反系统策略,仍然无法执行。
这一变化反映出 Agent 安全正在发生一个重要迁移:
从“控制模型怎么想”,逐渐转向“控制系统允许模型做什么”。
真正缺少的,是 Agent 的“可信度量体系”
论文最后指出,目前 Agent 领域存在一个明显的不平衡。
我们已经拥有越来越多衡量 Agent 能力的 Benchmark,却缺少成熟的 Trust Benchmark。
当前仍然缺乏统一的 Prompt Injection Benchmark;缺少能够验证数小时甚至数天 Goal Drift 的长期任务测试;缺少成熟的 Agent Memory Attack Benchmark;对于 Chain-of-Thought 的可信程度,也没有统一度量方法。
治理和合规方面的问题更加突出。
Agent 未来可能跨越多个系统、多个用户和多个司法管辖区运行,但目前几乎不存在成熟的跨监管 Agent Compliance Benchmark。
因此,Agent 安全未来真正需要建立的,可能不是又一个单点攻击数据集,而是一套与 Capability Benchmark 相对应的 Trust Benchmark。
不仅测:
Agent 能不能完成任务。
还要测:
它以什么方式完成任务,过程中有没有越权,是否保持目标一致,是否泄露信息,以及出了问题能否追溯。
从模型安全走向 AgentSecOps
TADL 目前仍然是一套概念性框架。
论文并没有通过真实生产系统验证它是否能够降低 Agent 安全风险,也没有证明六阶段和五道 Trust Gate 是最优的工程设计。因此,它更适合作为一种安全工程方法,而不是已经成熟的标准。
但它反映出的方向值得关注。
随着 Agent 能力不断增强,安全工作的重心正在逐渐从模型本身向整个系统迁移。
未来的 Agent 安全体系可能越来越多地包含传统软件和网络安全中的成熟机制:
IAM、最小权限、沙箱、策略引擎、审计日志、运行时监控、事件响应以及回滚。
Agent 的推理过程可能仍然难以完全理解,但系统至少可以知道:
它读取了什么数据、调用了什么工具、以什么权限执行、哪条策略允许了这次操作,以及最终改变了什么系统状态。
从这个角度看,Agent 安全正在从 Model Safety 进一步演化为 System Security。
而 TADL 所提出的六阶段生命周期,其真正意义也许就在这里:
安全不再是 Agent 上线之前的一次考试,而是贯穿设计、开发、运行和迭代全过程的一套持续控制机制。
声明:本文来自模安局,版权归作者所有。文章内容仅代表作者独立观点,不代表安全内参立场,转载目的在于传递更多信息。如有侵权,请联系 anquanneican@163.com。
